Bilanciamento VPN senza interruzioni: algoritmi, controlli di integrità e scalabilità nel 2026
Bilanciamento del carico per server VPN nel 2026: algoritmi, controlli di integrità, persistenza di sessione, scalabilità e resilienza. Consigli pratici, metriche, casi d’uso WireGuard, OpenVPN, IPsec e Anycast per un’infrastruttura VPN stabile.
Contenuto dell'articolo
- Perché bilanciare una vpn e perché è fondamentale nel 2026
- Pattern architetturali per il bilanciamento vpn: da l4 ad anycast
- Algoritmi di bilanciamento: da semplici ad avanzati
- Controlli di integrità e monitoraggio: non vedere solo la porta, ma la qualità del tunnel
- Persistenza di sessione per vpn: come "incollare" il client nel modo giusto
- Scalabilità vpn: verticale, orizzontale e autoscaling "intelligente"
- Sicurezza e resilienza: ddos, zero trust e compliance
- Casi pratici e modelli per openvpn, wireguard e ipsec
- Metriche, slo ed economia: come capire se tutto funziona
- Errori e antipattern: dove si scivola più spesso
- Piano passo-passo per implementare il bilanciamento vpn
- Casi di studio: cosa ha funzionato e cosa no
- Checklist pre-produzione: non dimenticare nulla
- Faq: domande frequenti sul bilanciamento vpn
Perché bilanciare una VPN e perché è fondamentale nel 2026
La VPN non è più solo "smart working", è una rete critica
Fino a pochi anni fa, la VPN nelle aziende era sinonimo di lavoro da remoto e accesso ai sistemi interni. Oggi è tutto diverso. Nel 2026 la VPN è il trasporto per Zero Trust, cloud ibridi, ambienti di sviluppo, accesso a cluster AI e edge computing. Se prima cadeva un server era un disagio, ora anche pochi minuti di inattività interrompono pipeline CI, compromettono transazioni e impattano il NPS. Il bilanciamento del carico dei server VPN non è più un "optional". È il pilastro della tua affidabilità di rete.
Perché è aumentato il carico? Monitoriamo traffico in tempo reale da supporto video, telemetria IoT, sincronizzazione dati per inferenza LLM ai margini della rete. E sì, la VPN non è più esclusivamente TCP: WireGuard e IPsec viaggiano su UDP e richiedono un approccio diverso per i controlli di integrità, i reindirizzamenti NAT e la persistenza delle sessioni. Si lavora veloce, si scala senza panico. O almeno così dovrebbe essere.
Il concetto chiave è semplice: senza una distribuzione intelligente delle richieste tra i nodi VPN, si rischia di sbattere contro limiti di CPU, EPOLL, socket e tabelle di stato. Il bilanciatore è il direttore d’orchestra della tua VPN che mantiene il ritmo e impedisce alla rete di stonare sotto carichi di picco.
Sintomi tipici di sovraccarico che sicuramente avrai già visto
Probabilmente ti sarà capitato di osservare situazioni simili. Gli utenti notano ping altalenanti e calo di banda nei momenti di maggior carico. La CPU di alcuni nodi schizza al 90-100% per il traffico in uscita, mentre altri nodi restano fermi. Alcuni si lamentano di continue riconnessioni, peer WireGuard spariscono per minuti, i login OpenVPN slittano a causa del timeout del handshake TLS. Ecco il bilanciamento incauto: un nodo fa tutta la fatica mentre gli altri si annoiano.
Aggiungi attacchi DDoS via UDP, impennate improvvise dopo un rilascio o all’inizio della giornata lavorativa, rotte instabili in una topologia multi-cloud. Senza un’architettura adeguata del bilanciamento si perdono SLA e si buttano soldi. E la cosa più frustrante è che spesso il problema si risolve non con hardware costoso, ma con algoritmi intelligenti e controlli di integrità. Quasi gratis, ma fatti bene e al momento giusto.
Cosa è cambiato nel 2026: nuove tendenze e realtà
Sono arrivati DPU/SmartNIC, offload eBPF/XDP, Anycast+BGP al perimetro, bilanciatori L4 cross-region da milioni di pacchetti al secondo e autoscaling basato su metriche reali di sessione. Usiamo sempre più Maglev e ring-consistent hashing, implementiamo stickiness per UDP basata su 5-tuple o peer-id e sfruttiamo la session resumption per TLS e IPsec IKEv2. Sono arrivati anche gli algoritmi post-quantistici, ancora in fase pilota, ma la crittografia è decisamente più pesante. E tutti cercano una "scalabilità in chiave minimalista": meno trucchetti complicati, più prevedibilità e automazione.
Pattern architetturali per il bilanciamento VPN: da L4 ad Anycast
Classico: bilanciatori L4 davanti al pool di nodi VPN
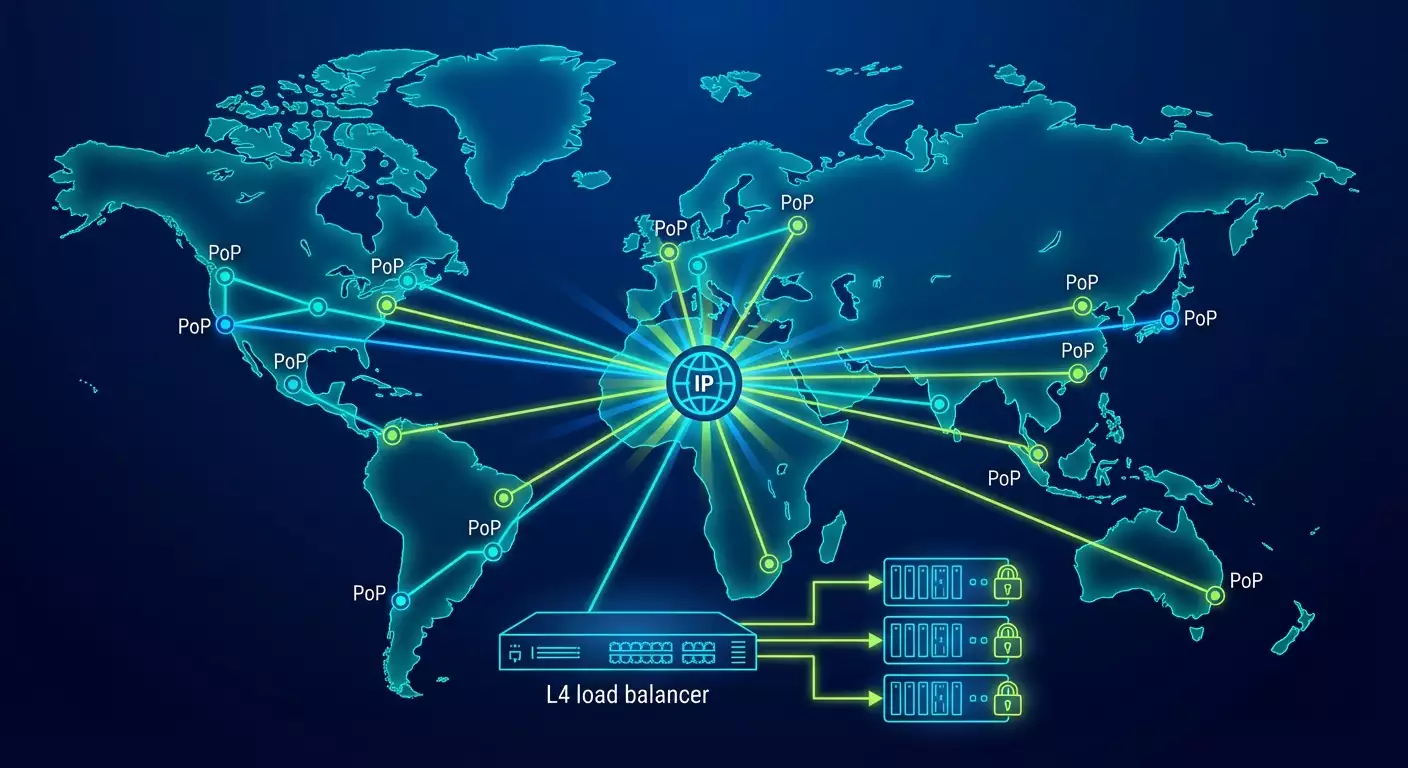
L’opzione più intuitiva è posizionare davanti al pool di server VPN un bilanciatore L4 che riceve le connessioni in ingresso e le distribuisce ai nodi. Funziona per OpenVPN (TCP o UDP), WireGuard (UDP), IPsec/IKEv2 (UDP 500/4500). Vantaggi: controllo centralizzato, controlli di integrità, autoscaling semplice. Svantaggi: potenziale single point of failure e necessità di stickiness corretta, soprattutto per UDP.
Cosa si usa realmente? HAProxy, Nginx Stream, Envoy (L4/L7), soluzioni commerciali e cloud NLB con forwarding diretto. L’obiettivo è garantire un percorso simmetrico e mantenere il "flow" sullo stesso nodo. Per TCP è più semplice: la sessione è stabile. Per UDP usiamo hash della sorgente/destinazione per non spezzare i tunnel. Su grandi carichi si adotta ECMP con configurazioni attente.
In ambienti critici si preferiscono coppie Active-Active di bilanciatori con VRRP/keepalived o meccanismi di high availability integrati. Sempre presente un monitoraggio Out-of-band che verifica non solo se la porta è attiva, ma lo stato reale dei tunnel.
Anycast+BGP al perimetro per PoP globali
Se hai molte regioni e PoP, Anycast è quasi una magia. Un unico IP viene annunciato da più siti tramite BGP e l’utente raggiunge il PoP più vicino secondo la routing del provider. Vantaggio: latenza minima e distribuzione geografica out-of-the-box. Dentro il PoP il traffico viene distribuito tra nodi L4 o DPU-bilanciatori. Siamo vicini all’esperienza di una CDN.
Anycast richiede però un rigido controllo del flapping delle rotte, prepends e community per priorità, e soprattutto failover preciso. Se un PoP diventa irraggiungibile, le rotte devono sparire rapidamente. Abbiamo casi con convergenza sotto i 30 secondi durante guasti e meno di 5 secondi negli L4 interni in caso di failure di health checks — gli utenti non si accorgono quasi di nulla.
Direct Server Return e forwarding senza copie inutili
Per massimizzare la banda si applicano tecniche come DSR. L’idea è che il traffico entrante passa dal bilanciatore, mentre quello uscente ritorna direttamente dai server al client senza transitare dal bilanciatore. Riduce il carico sul bilanciatore ma complica la rete. Nel mondo VPN è meno comune per la necessità di mantenere stato e cifratura, ma è una soluzione valida per gateway IPsec ad alte prestazioni in data center con routing simmetrico.
Da ricordare: DSR complica il debug e la diagnostica dei tunnel deve essere chiara. Se il team non è pronto, meglio un classico L4 ben scalato e con metriche trasparenti.
Algoritmi di bilanciamento: da semplici ad avanzati
Round Robin, Weighted RR e perché non bastano
Round Robin è veloce e semplice. Ma è cieco alla realtà: i nodi possono essere disomogenei e il carico può variare molto. Weighted RR aiuta a migliorare assegnando pesi basati su CPU/core o acceleratori di crittografia. Ma il traffico VPN è instabile, alcuni client generano gigabit, migliaia quasi dormono. Distribuire connessioni non equivale a distribuire traffico. Serve un approccio più "intelligente".
Nei casi reali Weighted RR è un punto di partenza, integrato poi da telemetria e adattamento dinamico dei pesi: ad esempio, con CPU al 75% il peso del nodo cala del 20%, all’85% del 50% e così via. Non è perfetto, ma attenua bene i picchi.
Least Connections / Least Load e metriche adattive
Least Connections è più adatto a TCP (OpenVPN-TCP), dove il numero di connessioni attive riflette il carico. Per tunnel UDP (WireGuard, IPsec) monitoriamo peer attivi e PPS/BPS. È nata la metrica "sessioni effettive": cliente ponderato dal traffico reale negli ultimi N secondi. Il bilanciatore assegna il nuovo flusso al nodo con carico "effettivo" minimo. Ecco il concetto di Least Load.
Nel 2026 è lo standard: un nuovo peer va allocato sulla base di metriche di CPU, IRQ softnet, PPS, BPS, drop/queue e numero di SA attivi (IPsec) o peers (WireGuard). I dati vengono raccolti via eBPF/Netlink/Prometheus a intervalli di 1-3 secondi. È importante filtrare il rumore usando smoothing esponenziale per evitare oscillazioni.
Consistent Hashing, Maglev e stickiness per UDP
La sfida UDP è che non esistono sessioni come nel TCP, ma c’è stato del tunnel. Serve stickiness nella distribuzione: un cliente deve finire sempre sullo stesso nodo, altrimenti ricrea il tunnel, perde pacchetti e si innervosisce. Si usa consistent hashing basato su 5-tuple, IP sorgente o ID cliente univoco. Maglev hash e ring-consistent hashing mantengono la maggior parte degli utenti sul nodo precedente anche aggiungendo o rimuovendo server.
Consiglio pratico: se il client ha CGNAT la source IP può variare. Usa allora chiavi basate su certificati client (OpenVPN), chiavi pubbliche peer (WireGuard) o identità da RADIUS/AAA. Serve un’entità stabile per il bilanciatore. Altrimenti la stickiness è debole e il tunnel migra ad ogni ricollegamento.
Controlli di integrità e monitoraggio: non vedere solo la porta, ma la qualità del tunnel
Controlli passivi e attivi
Controllare semplicemente se la porta TCP/UDP è aperta è il minimo, ma non basta. Eseguiamo controlli attivi: verifica handshake OpenVPN/TLS, IKE_SA per IPsec, ping diretto sull’interfaccia tunnel o pacchetti di test per WireGuard. Un buon controllo di integrità verifica non solo se il demone è vivo, ma anche se un peer di test scambia pacchetti criptati correttamente. Più complesso, ma catturi anche processi "vivi ma inutili" con routing rotto.
Complementiamo con telemetria passiva: tasso di perdita pacchetti, code qdisc, errori di crittografia, picchi di handshake falliti, e latenze tail P95/P99. Se P99 supera 200 ms per un PoP regionale è un segnale. Se drop-rate è sopra 0.1% è un segnale. Scegli tu le soglie secondo gli SLO. Nel 2026 è una normalità consolidata.
Controlli a cascata e rete di soluzioni
Un solo controllo non basta. Costruiamo cascade: ping L4 rapido ogni 2 secondi, test funzionali più estesi ogni 10-20 secondi, transazioni sintetiche (ad esempio una connessione di prova imitando un client) ogni minuto. La decisione di escludere il nodo dal pool si basa sulla maggioranza dei segnali per evitare che un sensore difettoso faccia saltare il servizio. Il reinserimento usa la stessa cascata ma con isteresi.
In più abbiamo test esterni da vantage point indipendenti: agenti esterni da ASN diversi controllano la raggiungibilità dei nodi Anycast e misurano latenze reali. Aiuta a scoprire problemi che all’interno sembrano assenti, ma che causano disagi agli utenti a causa di provider o problemi MTU. Abbiamo visto situazioni dove il percorso interno era verde, ma ECMP tagliava parte del traffico. Solo il test esterno ha mostrato il problema reale.
Falsi positivi e debouncing
Succede di sbagliare. UDP va perso, CPU esplode per un attimo, la garbage collection rallenta il processo. Usa debouncing: N controlli consecutivi falliti, finestre di osservazione, intervalli esponenziali. Registra non solo il fatto del fallimento ma il contesto — metriche fuori soglia, carico, cambi di configurazione. La diagnostica post-incidente è un upgrade gratuito.
Persistenza di sessione per VPN: come "incollare" il client nel modo giusto
Stickiness su 5-tuple, IP sorgente e ID utente
La soluzione base è la stickiness sulla 5-tuple: IP sorgente, porta sorgente, IP destinazione, porta destinazione, protocollo. Per TCP va bene. Per UDP, dove la porta sorgente può cambiare, meglio una chiave più stabile. In OpenVPN si può usare CN del certificato client o username RADIUS, in WireGuard la chiave pubblica peer, in IKEv2 IDi/IDr o identificatore EAP. L’ideale è che il bilanciatore legga questi campi durante l’handshake o lavori con un controller che fornisca il mapping.
Più la chiave è stabile, meno migrazioni ci sono. E più gli utenti sono soddisfatti: nessuno vuole tunnel che "saltano", anche se la riconnessione dura pochi secondi. Abbiamo misurato che spostare un peer su un altro nodo durante l’aggiornamento aumenta la latenza P99 del 30-60% per 1-2 minuti. Si risolve con buona stickiness e modalità drain.
Drain-mode, reload graduale e rolling updates
Gli aggiornamenti non devono impattare gli utenti. Prima di deployare una nuova versione o cambiare configurazione metti il nodo in drain: non accetterà nuovi client ma continuerà a servire quelli attivi. Dopo 5-15 minuti (a seconda dei timeout e attività tunnel) la maggior parte delle sessioni si sposterà naturalmente su altri nodi. Poi fai un graceful restart — con interruzioni minime o rotazione senza discontinuità dei processi worker. Solo dopo rimetti il nodo nel pool.
WireGuard è famoso per la semplicità ma fai attenzione che ricreare l’interfaccia può azzerare lo stato dei peer. Aggiorna con cautela: applicazione atomica della configurazione, caricamento anticipato del nuovo set di regole, poi switch. OpenVPN? Mantieni le sessioni con TLS session resumption e evita il cambio forzato delle chiavi nei picchi.
Condivisione dello stato e directory di sessione
Dove conservare lo stato se serve migrare? Alcune architetture usano una session directory — cache centrale per mappare client → nodo, accessibile al bilanciatore e al piano di controllo-distribuzione. Non replica lo stato di cifratura ma indirizza correttamente l’handshake successivo. Per IPsec esiste la sincronizzazione delle SA tra nodi attivi. Nel 2026 ci sono prodotti e soluzioni open-source che replicano parzialmente le SA o le ricostruiscono rapidamente in caso di failover. La replica completa non è sempre necessaria; spesso basta un "quick handshake" corretto con redirect appropriato.
Scalabilità VPN: verticale, orizzontale e autoscaling "intelligente"
Crescita verticale: quando conviene
Core potenti, AES-NI, ChaCha20-Poly1305, accelerazione DPU — tutto accelera la VPN. L’upgrade verticale chiude rapidamente i gap ma ha un limite: aumentano i costi, il rendimento decresce, e un guasto singolo impatta di più. Per installazioni piccole (fino a 2-3 Gbit/s) è conveniente. Oltre conviene andare in parallelo.
Come capire che hai raggiunto il massimo? Se un nodo regge 10-12 Gbit/s di traffico WireGuard con CPU al 70-80% e metriche IRQ ai limiti, è ora di scalare orizzontalmente. Applica tuning NUMA-friendly, pinning delle IRQ, RSS, aumenta net.core.rmem/wmem, bilancia MTU e spalma in larghezza.
Scalabilità orizzontale, cluster e Anycast
La scalabilità orizzontale è la tua migliore alleata. Aggiungi nodi, il bilanciatore distribuisce i peer, Anycast indirizza gli utenti verso il PoP più vicino. Il segreto è minimizzare il "costo" di aggiungere un nodo: bootstrap automatico, configurazioni GitOps, verifica readiness, inserimento nel pool. E lo stesso semplice drain per rimuoverlo.
Nei multi-cloud vediamo combo: NLB cloud regionali, dietro pool VM con WireGuard/OpenVPN, sopra config manager e monitoraggio esterno, davanti IP Anycast annunciati da più regioni. Funziona finché i controlli di integrità sono corretti e la stickiness per l’identità utente tiene.
Autoscaling con segnali giusti
Autoscaling basato solo su CPU è troppo grezzo. Nel 2026 conviene guardare "sessioni efficaci", PPS/BPS, latenze P95/P99, aumento di handshake falliti e drop-rate. Semplici regole soglia: se P95 della latenza sale del 30% in 3 minuti e PPS per nodo supera X, alza un nuovo nodo. Se il carico cala stabilmente per 15 minuti, metti un nodo in drain. Per evitare oscillazioni, imposta limiti min/max e periodi di cooldown tra le azioni.
Attenzione ai costi! Ogni nodo nuovo costa. Attiva politiche economiche: se il carico è stagionale (ad esempio 9-11) conviene mantenere una riserva "calda" del 10-15% sopra la media. Si paga in stabilità e tranquillità perché i picchi calano.
Sicurezza e resilienza: DDoS, Zero Trust e compliance
Protezione da UDP-flood e caratteristiche L7
La VPN è spesso su UDP. UDP è bersaglio prediletto per DDoS. Al perimetro usa filtri di frequenza, prefiltro provider, rate limiting eBPF per pacchetti handshake, tuning conntrack. Sul bilanciatore attiva flood protection e limitazione per AS in whitelist o geo (se accettato dal business). Non dimenticare cookie o "puzzle" di handshake in soluzioni commerciali: riduce il costo dell’attacco per te e aumenta quello per gli aggressori.
Al livello L7 per OpenVPN/TLS e IPsec/IKEv2 usa cipher suite rigorose, disabilita algoritmi obsoleti, applica Perfect Forward Secrecy, rinnova i certificati in tempo e usa HSM/DPU dove giustificato. Niente "MD5 temporanei". Mai.
Zero Trust e segmentazione
Una VPN senza segmentazione è come un mazzo di chiavi con tutte le porte aperte. Nel 2026 è out. Applica policy-based routing, verifica dispositivo (posture), token a breve durata e legami con identità (IdP, MFA). Segmenta per rotte, ACL e geografia del PoP. Il bilanciatore deve capire dove si applica la policy e quali nodi servono quali gruppi utente. È sicurezza, performance e controllo dei costi.
Conformità e logging
I log VPN sono documenti legali in molti settori. Conserva metadata di connessione, motivi di failure, versioni client, parametri crittografici. Anonimizza dove serve e rispetta le leggi regionali di conservazione dati. Se Anycast indirizza un utente in un’altra regione, accertati che la policy lo consenta. Il bilanciamento non deve rompere la compliance.
Casi pratici e modelli per OpenVPN, WireGuard e IPsec
WireGuard: UDP veloce e stickiness rigorosa
WireGuard ama minimalismo e velocità. Per bilanciare usa L4 con consistent hash sulla chiave pubblica peer. All’ingresso c’è l’IP Anycast al PoP, dentro NLB/HAProxy/Envoy con ring-hash. Controlli di integrità: peer di test, verifica keepalive, monitor handshake. Per autoscaling: metriche PPS/BPS e numero di peer attivi. Aggiornamenti con drain e applicazione atomica config. Così abbiamo gestito 60mila peer simultanei con P99 sotto 120ms in 3 regioni.
Tuning: net.core.rmem_max, rmem_default, busy_poll sulle interfacce, offload corretto su NIC, IRQ pinning su core. Cipher ChaCha20-Poly1305 accelera scenari CPU-bound. Sicurezza: limita nuovi peer durante attacchi, attiva rate-limit sugli handshake.
OpenVPN: TCP/UDP e flessibilità
OpenVPN resta "tuttofare". Per TCP bilanciamento semplice: Least Connections più session resumption, stickiness su sessione TLS. Per UDP stickiness su CN del certificato o username, altrimenti le reconnessioni saltano. Controlli: handshake TLS di prova, ping tunnel, logging renegotiation. Per installazioni grandi: separa control e data plane, shard per gruppi utente.
Caso d’uso: fintech con 1 milione MAU e picco di 85mila sessioni simultanee. Sono passati da RR statico a Least Load adattivo su CPU+PPS+latenza P95, introdotto drain-mode ai rilasci, ridotto i reconnection del 42% e la latenza P99 del 35% la sera. Tutto senza nuovi hardware.
IPsec/IKEv2: affidabile e un po’ "heavy"
IPsec è ottimo per site-to-site e mobile enterprise. Bilanciamento con Anycast al perimetro, poi L4 con consistent hashing su ID IKE (IDi) o login EAP. Fondamentale sincronizzare SA al failover. Se non esiste replica completa, garantisci rekey rapido con redirect corretto. I controlli includono SA di test e controllo perdite ESP. Non dimenticare NAT-T su UDP 4500 e grandi MTU/frammentazione. Prestazioni molto migliorate da offload hardware su SmartNIC/DPU.
Metriche, SLO ed economia: come capire se tutto funziona
Set di metriche per nodo e cluster
Non guardare solo CPU e memoria. Critiche sono PPS/BPS in entrata e uscita, sessioni/peer attivi, rate handshake, drop/queue sulle interfacce, latenze P50/P95/P99, errori crittografia, ritrasmissioni TCP, frammentazione UDP. Metriche interne del bilanciatore: distribuzione algoritmi, percentuale di violazioni stickiness, tempo di reazione a failure health. Permettono di individuare anomalie tempestivamente.
Nel cluster misura anche l’uniformità: coefficiente di variazione del carico tra nodi. Se CV supera 0.25 a lungo, l’algoritmo non regge o ci sono clienti "pesanti". Applica quote per cliente o gruppo: limita PPS di picco per evitare che un utente rovini la vita a tutti.
SLO e alert senza isterismi
Definisci SLO: disponibilità Anycast PoP al 99.95% mensile, latenza P99 < 150 ms regionale, tasso di riconnessioni < 1.5% all’ora su 10k sessioni, handshake error < 0.4%. Alert solo se superano soglie per più di N minuti, con soppressione dei "picchi storm". Nei report non solo "semaforo rosso" ma raccomandazioni: aggiungi nodo, attiva drain, verifica routing in ASN-X, aumenta MTU.
Costo e pianificazione di capacità
I soldi contano. Pianifica capacità in base alle finestre temporali "pesanti" reali. Analizza storico: che percentuale di carico fa l’1% top degli utenti? Se è troppo alta, applica rate-limit. Mantieni riserva del 20% a PoP, 10% a livello globale. Collega autoscaling a budget per evitare espansioni notturne del 200% causate da bug nelle metriche.
Errori e antipattern: dove si scivola più spesso
Bilanciare per connessioni, non per carico
Errore classico: contare sessioni e ritenersi soddisfatti. Risultato: un nodo si prende diversi "elefanti" di traffico, gli altri solo "topolini", anche se le sessioni sono equamente divise. Cura: usa metriche PPS/BPS e Least Load con pesi basati sul carico reale. Aggiungi quote per gli "elefanti".
Controllo di integrità "porta viva" e fine
La porta può essere aperta ma il tunnel rotto. Aggiungi test funzionali, transazioni sintetiche, probe esterne. Metti isteresi e cascade di decisioni per non saltare su ogni guasto temporaneo.
Mancanza di drain-mode e aggiornamenti graduali
Rollback del rilascio, utenti disconnessi a raffica, SLA che cade. Non fare l’eroe. Attiva drain, aspetta il naturale esaurimento sessioni, esegui l’aggiornamento, rimetti in pool. Calmo e senza sbalzi.
Piano passo-passo per implementare il bilanciamento VPN
Step 1. Misura, non supporre
Raccogli metriche: PPS/BPS, peer, rate handshake, latenza, drop. Costruisci profili temporali e individua i picchi. Senza dati ogni decisione è un gioco di fortuna.
Step 2. Scegli l’architettura
Scala piccola/mediana: bilanciatore L4 davanti al pool, stickiness per ID utente, health check con peer di test. Scala globale: Anycast+BGP al perimetro, dentro NLB/HAProxy/Envoy, autoscaling e probe esterne da ASN differenti.
Step 3. Configura algoritmi e stickiness
Parti da Least Load e hashing consistente su ID stabile (CN, chiave pubblica, IDi). Controlla oscillazioni di distribuzione con aggiunta/rimozione nodo. Attiva quote per "elefanti" e migrazione graduale in drain.
Step 4. Health check e cascade di decisioni
Crea check L4 veloci, test funzionali più lenti e probe sintetiche esterne. Definisci soglie, finestre temporali e politiche di reinserimento. Documenta tutto, ti ringrazierai al primo incidente.
Step 5. Autoscaling ed economia
Leva autoscaling su metriche di qualità (P95, drop) e carico (PPS/BPS). Imposta min/max nodi, budget, cooldown tra azioni. Testa scenari "tempesta" di connessioni e attacchi UDP in laboratorio.
Step 6. Sicurezza e compliance
Verifica politiche crittografiche, log e segmentazione. Attiva rate-limit sugli handshake, filtri perimetrali, verifica MTU. Considera SmartNIC/DPU se giustificato economicamente.
Casi di studio: cosa ha funzionato e cosa no
Caso 1: Fintech e picchi serali
Cliente con picco serale: report analitici mobile via VPN fino a 85mila sessioni simultanee. Passaggio da Weighted RR a Least Load, stickiness sul CN, aggiunta di drain-mode, health check su tre livelli. Risultato: latenza p99 ridotta del 35%, reconnessioni calate del 42%, risparmio di 2 nodi grazie a distribuzione equilibrata.
Caso 2: Anycast e multi-cloud
SaaS globale con PoP in 6 regioni. Anycast ha indirizzato gli utenti al PoP più vicino, dentro NLB con ring-hash sulla chiave pubblica WireGuard. Il monitoraggio esterno ha permesso di disabilitare regioni degradate in 20-30 secondi tramite modifiche BGP e health check rapidissimi. Disponibilità del 99.97% trimestrale.
Caso 3: DDoS e soffocamento degli handshake
Flood UDP sulle porte WireGuard ha scatenato un’ondata di handshake. Implementato rate limit eBPF, controllo cookie durante handshake, filtro provider potenziato. Ridotta la frequenza degli handshake ripetuti. Latency P95 è tornata normale in 7 minuti, con un leggero rallentamento percepito in 5 minuti di picco.
Checklist pre-produzione: non dimenticare nulla
Tecnico
- Algoritmo di distribuzione: Least Load + hashing consistente
- Stickiness su identificatore cliente stabile
- Cascade di health check: veloce, funzionale, probe esterne
- Drain-mode e aggiornamenti graduali
- Autoscaling con P95/PPS/BPS e limiti di budget
- Log, alert, SLO e post-mortem
Rete
- Anycast+BGP per PoP globali
- MTU corretti e gestione frammentazione
- Simmetria ECMP e diagnostica rotte
- Filtri perimetrali, rate-limit sugli handshake
Organizzativo
- Documentazione e runbook
- Test di incidente e simulazione "tempesta"
- Allineamento compliance per regioni
- Piano rollback in 5 minuti
FAQ: domande frequenti sul bilanciamento VPN
Quale algoritmo scegliere per iniziare
Inizia con Least Load e hashing consistente su ID stabile cliente. Garantisce distribuzione equilibrata e sessioni stabili senza oscillazioni con l’aggiunta di nodi. Round Robin lascia per ambienti di test.
Serve Anycast se ho un solo paese
Se hai più regioni in un paese e gli utenti sono geograficamente distribuiti, Anycast aiuta a ridurre latenza e aumentare resilience dei PoP. Per un’unica città e PoP il beneficio è minimo: concentrati su un buon L4 e health check.
Come impostare stickiness per WireGuard
Usa hashing consistente sulla chiave pubblica peer. È più stabile dell’IP sorgente, soprattutto con CGNAT. Mantieni mapping peer → nodo a livello di bilanciatore o controller per evitare che l’handshake finisca su un altro server.
Cosa controllare oltre alla porta nei health check
Handshake, scambio pacchetti di test sul tunnel, latenze P95/P99, drop rate, errori crittografici, code in crescita. Probe esterne da ASN diversi sono un must per catturare problemi provider.
Come aggiornare senza downtime
Attiva drain-mode, aspetta il naturale esaurimento delle sessioni, esegui restart graduali o senza interruzioni. Per WireGuard applica config atomiche, per OpenVPN session resumption, per IPsec rapido rekey con redirect corretto.
Vale la pena investire in DPU/SmartNIC
Se punti decine di gigabit per nodo e serve bassa latenza sotto carico, DPU/SmartNIC sono un investimento valido. Per installazioni piccole conviene mettere a punto bilanciamento L4, autoscaling e stack di rete.
Quali SLO impostare all’inizio
Disponibilità 99.9-99.95% per PoP, latenza P99 < 150 ms per utenti regionali, tasso riconnessioni < 2% all’ora su 10k sessioni, errori handshake < 0.5%. Poi raffina con la maturità.
