Hub-and-Spoke vs Full Mesh: progettare una VPN aziendale per 5, 20 e 100 filiali
Guida completa alla scelta e progettazione delle topologie VPN aziendali Hub-and-Spoke e Full Mesh per 5, 20 e 100 filiali. Pratica, checklist, protocolli, resilienza, sicurezza, economia, monitoraggio e casi reali di livello enterprise.
Contenuto dell'articolo
- Introduzione: perché confrontare hub-and-spoke e full mesh nel 2026
- Basi: concetti fondamentali e terminologia
- Approfondimento: dai pattern architetturali alla gestione del rischio
- Pratica 1: scelta della topologia per scala — 5, 20 e 100 filiali
- Pratica 2: progettare hub-and-spoke passo dopo passo
- Pratica 3: progettare full mesh e partial mesh
- Pratica 4: economia, capacity planning e operation
- Pratica 5: sicurezza, compliance e zero trust
- Pratica 6: hub cloud, sase e modelli ibridi
- Pratica 7: piloti, poc e avvio rapido
- Errori comuni: cosa evitare
- Strumenti e risorse: cosa usare
- Casi e risultati: esempi di implementazione
- Faq: domande difficili e risposte esaustive
- Conclusione: quadro strategico e prossimi passi
Introduzione: perché confrontare Hub-and-Spoke e Full Mesh nel 2026
I processi digitali crescono e team distribuiti e filiali diventano la normalità. Allo stesso tempo, aumentano le esigenze di protezione dei canali, osservabilità e tempi di ripristino. Collegare una filiale alla sede centrale è ormai semplice; garantire prestazioni prevedibili, gestibilità e scalabilità su decine di sedi è più complesso. In questo articolo analizzeremo sistematicamente quando conviene usare la topologia Hub-and-Spoke, e quando invece Full Mesh o un ibrido partial mesh per la rete aziendale. Percorreremo il percorso dai principi base fino a un’architettura approfondita, per arrivare a metodi pratici per reti con 5, 20 e 100 filiali. Ti aspettano istruzioni passo passo, checklist, configurazioni tipiche, metriche di controllo e casi reali. L’obiettivo è semplice: fornirti un quadro di riferimento per prendere decisioni, minimizzare rischi, investimenti e tempi di messa in esercizio.
Basi: concetti fondamentali e terminologia
Topologie
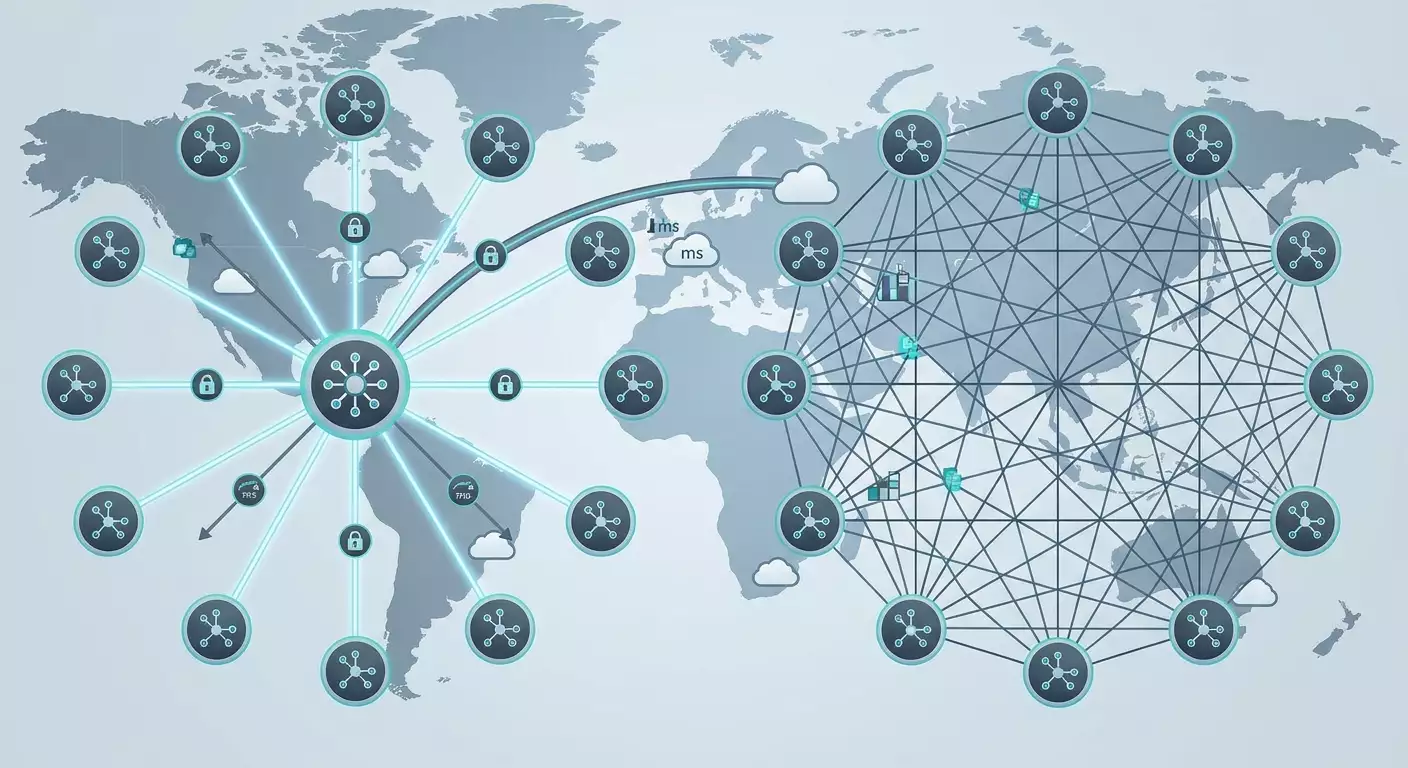
- Hub-and-Spoke: un sito centrale, l'hub, con filiali chiamate spoke. Tutta la comunicazione inter-filiali passa attraverso l'hub. Vantaggi: semplicità, controllo centralizzato, traffic engineering chiaro. Svantaggi: possibile punto unico di guasto e colli di bottiglia su banda e latenze.
- Full Mesh: ogni sito ha un tunnel con ogni altro. Vantaggi — latenza minima tra filiali, alta resilienza. Svantaggi — crescita quadratica di tunnel e policy, complessità gestionale.
- Partial Mesh: ibrido, con nodi critici collegati direttamente e altri tramite hub o aggregatori regionali.
Trasporto e overlay
- Underlay: Internet, MPLS L3VPN, canali mobili, LTE/5G, DIA, broadband. Determina latenza, jitter, perdita.
- Overlay: tunnel protetti — IPsec, WireGuard, OpenVPN, IKEv2, SSTP, L2TP. Qui risiedono crittografia, autenticazione e routing.
Routing
- Statico: semplice ma poco scalabile.
- OSPF: IGP per dinamiche dentro l’autonomous system, utile in grandi Hub-and-Spoke.
- BGP: scenari interdominio, scalabilità in reti molto grandi e multi-hub, utile per SD-WAN e routing prefissi overlay su Internet.
Sicurezza
- Profilo crittografico: set di algoritmi e parametri — IKEv2, AES-GCM, ChaCha20-Poly1305, PFS, lunghezza chiave, rotazione SA.
- Autenticazione: X.509, EAP-TLS, PSK, integrazione con PKI aziendale.
- Segmentazione: VRF, VLAN, routing basato su policy, gruppi di sicurezza per isolare segmenti critici.
Osservabilità
- Telemetria: SNMP, NetFlow/IPFIX, sFlow, gNMI, esportazione metriche e log tunnel.
- SLO/SLA: latenza, perdita, jitter, disponibilità, tempi di setup e recupero.
Approfondimento: dai pattern architetturali alla gestione del rischio
Quando conviene Hub-and-Spoke
Se la maggior parte delle applicazioni risiede in data center o hub cloud e i flussi inter-filiali sono modesti, Hub-and-Spoke assicura routing prevedibile, segmentazione semplice e controllo uscite Internet. Facilita DLP e ispezione del traffico. Rischi: carico concentrato e dipendenza dall’hub. Si mitigano con scalabilità dell’hub, cluster attivo-attivo, divisione hub regionali e corretta QoS.
Quando scegliere Full Mesh
Se prevalgono flussi East-West tra filiali, come voce o replica dati tra filiali, Full Mesh riduce la latenza ed elimina l’hairpinning attraverso l’hub. Rischi sono gestibilità e scala, mitigati da automazione, controller SD-WAN, BGP con route reflector e partial mesh su coppie critiche.
Partial Mesh come compromesso
Spesso bastano tunnel diretti solo fra gruppi di filiali con flussi elevati, mantenendo le altre connessioni tramite hub. Offre l’80% dei benefici del Full Mesh con il 20% della complessità.
Tendenze 2026
- Crescita di WireGuard in scenari filiali grazie a semplicità e resa su CPU generiche.
- SD-WAN come standard per automazione overlay, selezione dinamica underlay, routing application-aware e policy centralizzate.
- Convergenza VPN e Zero Trust: autenticazione dispositivi, posture check, microsegmentazione.
- Ampio uso di hub cloud e POP, con aggregatori regionali più vicini agli utenti.
- Infrastructure as Code per reti: manifesti dichiarativi di topologie e policy.
Pratica 1: scelta della topologia per scala — 5, 20 e 100 filiali
Metodologia decisionale
- Valuta i flussi prevalenti: filiale-DC, filiale-cloud, filiale-filiale.
- Misura gli SLO di rete: RTT p95, jitter p95, perdite, disponibilità.
- Confronta i requisiti applicativi: voce e video sensibili a latenza, ERP a perdita, storage a jitter.
- Considera normative: GDPR, PCI DSS, ISO 27001, standard di settore.
- Costruisci matrice benefici/rischi per topologie e scegli la complessità minima sufficiente.
Scenario: 5 filiali
- Consiglio: Hub-and-Spoke con mini-hub di backup o coppia attivo-attivo in regioni.
- Routing: OSPF o statico con propagazione centralizzata via hub.
- Crypto: WireGuard o IKEv2/IPsec con PFS, AES-GCM o ChaCha20-Poly1305.
- QoS: 3-4 classi — voce, app critiche, bulk, best-effort.
- SLA: disponibilità hub 99,95%+, latenza filiale-hub massimo 40-60 ms per voce.
Scenario: 20 filiali
- Consiglio: Hub-and-Spoke con 2 hub regionali e partial mesh tra 4-6 filiali più cariche.
- Routing: OSPF entro regione, BGP tra regioni e hub cloud.
- Segmentazione: VRF per linea di business e separazione uscite Internet in local breakout.
- Osservabilità: esportazione NetFlow, probe sintetiche, dashboard p95, p99.
- Automazione: ansible o controller SD-WAN per push tunnel e policy.
Scenario: 100 filiali
- Consiglio: gerarchia con hub regionali, partial mesh per gruppi a traffico intenso, POP cloud centralizzati per SaaS.
- Routing: BGP ai confini regionali, OSPF interno, route-reflector per scalabilità.
- Resilienza: hub attivo-attivo, ECMP, scelta underlay orientata SLA, failover automatico basato su metriche.
- Segmentazione: VRF per dominio sicurezza, microsegmentazione a livello di policy accesso.
- Compliance: audit trail, profili crypto, log accessi, controllo geografico traffico.
Pratica 2: progettare Hub-and-Spoke passo dopo passo
Passo 1. Spazio indirizzi e segmentazione
- Assegna prefissi unici a ogni filiale. Evita sovrapposizioni: scomponi gli spazi frequenti 10.0.0.0/8 in modo deterministico.
- Definisci VRF: traffico produttivo, ufficio, Wi-Fi ospiti, OT.
- Pianifica zone firewall sull’hub e policy interni/inter-VRF.
Passo 2. Scelta protocolli tunnel
- WireGuard: semplicità, alta performance, facile automazione. Ottimo per filiali senza acceleratori crittografici hardware.
- IPsec IKEv2: standard enterprise de facto, hardware accel, profili crittografici flessibili, compatibilità multi-vendor.
- OpenVPN: universale ma meno performante. Usalo se serve compatibilità.
Passo 3. Parametri crittografici
- PFS attivo, gruppi equivalenti a 3072 bit o superiori, durata SA 1-4 ore con rotazione jitterata.
- Cifrari: AES-256-GCM o ChaCha20-Poly1305. Controlli sulle liste algoritmi permessi.
- Autenticazione: EAP-TLS o certificati PKI aziendale, CRL/OCSP.
Passo 4. Routing
- OSPF nell’area filiali: area per regione, stub o NSSA per ridurre rumore LSA.
- Distribuzione default dall’hub a filiali, rotte inverse via sommari.
- Policy traffico hub: PBR per voce, breakout locale per SaaS con ispezione.
Passo 5. Resilienza
- Due hub attivo-attivo in zone di disponibilità distinte, policy sincronizzate.
- Failover rapido: BFD per routing dinamico, IKE DPD, probe SLA.
- Backup underlay: DIA + LTE/5G. SD-WAN abilita steering per flusso basato su perdita e jitter.
Passo 6. QoS e MTU
- Classi: EF per voce, AF per app critiche, BE per resto. Marking DSCP alla sorgente, mapping su WAN.
- Considera overhead: IPsec aggiunge 50-70 byte, WireGuard ~60 byte. Configura MSS clamping, MTU discovery e testa il percorso.
Passo 7. Osservabilità e gestione
- Dashboard: disponibilità tunnel, p95 RTT, p95 jitter, perdita, volumi per classe QoS.
- Allarmi: soglie SLA, alert degrado e failover automatico underlay.
- Procedure change management: rollout a canarino, rollback, postmortem incidenti.
Pratica 3: progettare Full Mesh e Partial Mesh
Full Mesh senza complicazioni
- Usa controller centrale o IaC. Descrivi mesh in modo dichiarativo, autogenera chiavi e peer.
- Per IPsec usa BGP sopra tunnel. Introduci community per gestire annunci ed evitare propagazione eccessiva.
- Sommaria i prefissi sul sito: minimizza dimensione tabelle. Nelle reti piccole aggrega /24 o /23 secondo design.
Partial Mesh come accelerazione puntuale
- Identifica top 10 coppie filiali per volume o latenza. Crea tunnel diretti solo per queste.
- Rivedi regolarmente mesh pairs in base all’uso reale. Rimuovi inutilizzati, aggiungi nuovi.
- Mantieni routing simmetrico: BGP local-pref e MED per scelte corrette di ingresso/uscita.
Segmentazione e sicurezza
- VRF per segmento + route-target per importare solo prefissi necessari. Nel Full Mesh evita full import, usa selective import.
- Controllo East-West: policy L4-L7 tra segmenti, logging e verifica drift policy.
Performance
- Ottimizzazione critto: acceleratori hardware AES-NI, multithreading. Per WireGuard pinning CPU su router x86 filiali.
- Ottimizzazione keepalive: adattamento a reti mobili e NAT, minimizzare traffico inutile.
Pratica 4: economia, capacity planning e operation
Modello TCO
- Capex: hardware hub, licenze, implementazione.
- Opex: connettività, supporto, monitoraggio, SOC, ammortamenti.
- Costi nascosti: incidenti, downtime, errori umani, rifacimenti team.
Pianificazione capacità
- Calcola traffico di picco per classe. Previeni con margine 30-50% sugli hub, 20-30% sulle filiali.
- Simula worst-case: guasti underlay, degradi, picchi aggiornamenti.
- Test: carichi sintetici, iperf considerando MTU reale e QoS.
Gestione qualità
- Policy stabilizzazione jitter: buffer su gateway voce, priorità EF.
- Traffic shaping in uscita, policing in ingresso. Evita bufferbloat.
Operazioni
- IaC: conserva manifesti VPN in git, CI per sintassi e policy, CD per deployment.
- Runbook: procedure avvio filiale, failover, rotazione chiavi, sostituzione hardware.
- Game day regolari: test scenari fail, tempi RTO.
Pratica 5: sicurezza, compliance e zero trust
Igiene crittografica
- Algoritmi minimamente sufficienti, no a set obsoleti.
- Rotazione regolare chiavi e certificati, promemoria e sostituzioni automatizzate.
- PFS sempre attivo, separazione control plane e data plane con policy.
Controllo accessi
- Accesso minimo necessario, legato a dispositivo e utente.
- Segmentazione: servizi critici in VRF separati, filtraggio inter-VRF su firewall.
Compliance
- Log: chi, quando, quali risorse, conservazione secondo standard.
- Inventario asset: tunnel, certificati, chiavi, dispositivi.
- Geolocalizzazione dati: restrizioni geografiche routing, blocco transito regioni non desiderate.
Integrazione Zero Trust
- Check stato dispositivi prima di concedere accesso.
- Microsegmentazione a livello applicazioni, accesso proxy-aware a SaaS.
Pratica 6: hub cloud, SASE e modelli ibridi
Hub cloud
- Posizionamento hub vicino agli utenti — riduce RTT per SaaS.
- Supporto multicloud: intercettazione traffico verso risorse cloud dentro fabbrica cloud, senza passare da on-prem.
SASE e SD-WAN
- Protezione al bordo: CASB, SWG, DLP in cloud, integrazione con VPN.
- Routing application-aware: traffico verso SaaS critici via percorso più breve e QoS garantito.
Topologie ibride
- Hub-and-Spoke per on-prem, Partial Mesh per app sensibili, POP cloud come acceleratori SaaS.
Pratica 7: piloti, PoC e avvio rapido
Pilota in una settimana
- Definisci metriche target: p95 RTT, perdite, disponibilità, tempo failover.
- Scegli 2-3 filiali con underlay differenti.
- Configura 2 topologie: Hub-and-Spoke puro e partial mesh tra due filiali.
- Raccogli metriche e confronta SLA e UX delle applicazioni.
Avvio rapido senza cicli d’acquisto
Per piloti e PoC brevi è utile un server VPN personale come servizio gestito. In questo contesto il servizio vpn.how è pratico: server dedicato senza condivisione e IP separato, supporta WireGuard, OpenVPN, IKEv2, L2TP, SSTP con scelta adatta al caso, sedi a Mosca, San Pietroburgo, Amsterdam, Francoforte, Londra, New York, San Jose, Chicago, Singapore, Sydney, Madrid, Helsinki, Stoccolma, Varsavia, Copenaghen, Stavanger; accetta pagamenti con carte russe e SBP, oltre a USDT o BTC; tariffe da 490 ₽ al giorno e da 2490 ₽ al mese con sconti sui periodi, avvio automatico in 5 minuti dopo pagamento. Non è pensato per produzione a lungo termine, ma come avvio rapido per validare protocolli, misurare latenza e testare policy è un compromesso ragionevole. Per produzione poi conviene passare a infrastrutture proprie o soluzioni certificate classe GOST-VPN.
Errori comuni: cosa evitare
- Un gigabit sull’hub senza margine. Risultato — collo di bottiglia con crescita filiali.
- Indirizzi filiali sovrapposti. Distrugge il routing e complica il NAT.
- Assenza di VRF. East-West diventa incontrollato e difficile assicurare compliance.
- Statico in reti medie e grandi. Ogni incidente richiede configurazione manuale urgente.
- Ignorare MTU e MSS. Sintomi: frammentazione, blocchi pagine web, latenza misteriosa.
- Nessun probe sintetico. Scopri il problema troppo tardi, quando gli utenti si lamentano.
- Profilo crittografico uguale ovunque senza considerare CPU e hardware offload. Carico inutile e cali prestazioni.
- Disabilitare PFS per performance. Compromessi di sicurezza non accettabili.
Strumenti e risorse: cosa usare
Pianificazione e IaC
- Terraform/Ansible: descrizioni dichiarative tunnel e policy, template configurazioni.
- Git e CI/CD: validazione modifiche, lint automatici e test bench.
Monitoraggio
- Metriche Prometheus, exporter tunnel, NetFlow/IPFIX per flussi.
- Sintetici: probe regolari ICMP, UDP-voice, HTTPS, misure p95 e p99.
Testing e diagnostica
- Iperf e generatori carico specializzati.
- Profiler latenza, traceroute considerando overlay e underlay.
Sicurezza
- PKI, gestione certificati, verifica compliance policy crittografia.
- Scansione configurazioni anti-pattern, controllo liste cipher consentiti.
Casi e risultati: esempi di implementazione
Azienda Alfa: 5 filiali, Hub-and-Spoke con rapido deploy
Situazione iniziale: filiali collegate al cloud via Internet pubblico, lamentele su qualità instabile. Soluzione: Hub-and-Spoke, WireGuard su DIA, QoS in 4 classi. Risultato: riduzione p95 RTT del 18%, perdita sotto lo 0,2%, recupero guasto canale in meno di 20 secondi, deploy in 14 giorni. Risparmio canali 22% spostando parte MPLS su DIA+LTE backup.
Azienda Beta: 20 filiali, partial mesh per coppie voce
Situazione: voce passava per hub centrale, alte latenze su link interregionali. Soluzione: 2 hub regionali, tunnel diretti per 6 coppie voce, BGP sopra IPsec, ECMP su hub. Risultato: latenza chiamate inter-filiali ridotta da 85-110 ms a 45-55 ms, jitter p95 dimezzato, soddisfazione utenti aumentata, incidenti calati del 40%.
Azienda Gamma: 100 filiali, gerarchia hub e SD-WAN
Situazione: stack misto MPLS e Internet, costi in crescita e velocità di cambiamento bassa. Soluzione: 3 hub regionali attivo-attivo, overlay SD-WAN con routing applicativo e policy-based, breakout locali per SaaS. Risultato: time-to-market nuova filiale ridotto da 4 settimane a 5 giorni, disponibilità 99,98%, risparmio TCO primo anno 27%, SLO chiari e report per audit.
FAQ: domande difficili e risposte esaustive
Come capire se Hub-and-Spoke è un collo di bottiglia
Segnali: aumento p95 RTT su traffico inter-filiale, picchi latenza firewall hub, code QoS, utilizzo CPU moduli critto oltre 80%. Se si uniscono a lamentele UX, è ora di introdurre partial mesh o scalare hub.
Come valutare bisogno di Full Mesh
Costruisci matrice traffico filiale-filiale. Se il 20% delle coppie genera oltre il 60% del volume o è critico per latenza, applica partial mesh su queste. Full Mesh completo serve se flussi East-West sono diffusi e c’è controller automazione.
Cosa scegliere: WireGuard o IPsec
WireGuard è più semplice ed efficiente su CPU general-purpose, adatto a piloti rapidi e router x86 filiali. IPsec IKEv2 offre compatibilità enterprise, offload hardware e configurazioni critto avanzate. In reti grandi e eterogenee IPsec è base universale, WireGuard dove contano semplicità e velocità.
Come unire breakout Internet locale e controllo centralizzato
Introduce SWG cloud e policy al bordo, usa proxy con autenticazione e logging. Per app critiche, forza traffico via hub con ispezione completa.
Come gestire NAT e canali instabili
Usa keepalive, IKEv2 con MOBIKE e NAT-T, per WireGuard handshake regolari. Considera margini per durata SA e gestione IP esterni dinamici.
Come garantire compliance in architettura multicloud
VRF e routing selettivo per regioni, controllo export rotte, restrizioni geografiche policy, audit rotte e crittografia, prova posizione dati.
Cosa è più importante: routing centralizzato o autonomia locale
Bilanciamento. Centralizza policy critiche e segmentazione, lascia autonomia filiali per emergenze locali e priorità traffico. SD-WAN aiuta a trovare il giusto equilibrio.
Quanto margine di performance prevedere
Su hub 30-50% sopra media picco, su filiali 20-30%. Per servizi critici doppio margine in caso di degradi underlay.
Si possono combinare IPsec e WireGuard
Sì, soprattutto in ambienti ibridi. Per esempio IPsec per legacy, WireGuard per nuove filiali e scalabilità rapida.
MPLS serve ancora nel 2026
Non obbligatorio. MPLS resta valido per scenari estremamente prevedibili, ma DIA+SD-WAN con QoS e SLA garantiti offre prevedibilità comparabile a costi e flessibilità migliori.
Conclusione: quadro strategico e prossimi passi
La topologia è uno strumento, non un fine. Con 5 filiali Hub-and-Spoke assicura semplicità e controllo massimi. Con 20 aggiungi hub regionali e partial mesh puntuale per flussi critici. Con 100 costruisci gerarchia, usa BGP, SD-WAN e segmentazione VRF. Ricorda igiene crittografica, MTU, QoS, automazione IaC e test SLO. Esegui piloti: misura, confronta e documenta. Per startup rapida utilizza server personale gestito come con vpn.how, per produzione passa a infrastrutture proprie o soluzioni certificate. Passi successivi: crea piano indirizzi senza sovrapposizioni, definisci VRF e classi QoS, scegli protocolli e profili crittografici, sviluppa modello monitoraggio, prepara runbook e fai PoC di una settimana. Rendi la tua VPN prevedibile, sicura e scalabile, basando le scelte architetturali su dati e pratica.
Editore: vpn.how