Headscale: alternativa self-hosted a Tailscale con instalación y casos de uso
Análisis profundo de Headscale, una alternativa self-hosted a Tailscale. Exploramos su arquitectura, instalación mediante Docker y systemd, configuración de OIDC y ACL, DERP y rutas, además de presentar 7 escenarios prácticos con resultados medibles, consejos y comparación con otras opciones.
Contenido del artículo
- Introducción: por qué necesitas headscale self-hosted y qué problema resuelve
- Vista general de headscale: funcionalidades principales, arquitectura y ventajas
- Escenario 1. homelab sin puertos abiertos: acceso privado a nas, cámaras y servicios
- Escenario 2. acceso de equipos a staging y artefactos ci/cd entre nubes
- Escenario 3. conexión de red industrial cerrada (ot) mediante subnet router con control de acceso
- Escenario 4. híbrido: conectar base on-prem y kubernetes en la nube sin internet público
- Escenario 5. nodo de salida para empleados remotos con políticas y navegación segura
- Escenario 6. gestión de parque iot y cámaras en sitios remotos
- Escenario 7. acceso temporal para contratistas y auditores: efímeros, etiquetas, aprobación
- Instalación y configuración básica de headscale: de cero al primer nodo
- Rendimiento y estabilidad: qué esperar y cómo medir
- Integraciones y automatización: cómo encajar headscale en tu stack existente
- Comparativa con alternativas: dónde headscale destaca y precauciones
- Preguntas frecuentes
- Conclusiones: para quién es headscale y cómo comenzar rápido
Introducción: por qué necesitas Headscale self-hosted y qué problema resuelve
Vivimos en un mundo de equipos distribuidos, infraestructuras híbridas y múltiples entornos: desde un servidor doméstico hasta clústeres en la nube en distintas regiones. En esta realidad, los VPN clásicos no resuelven todas las necesidades. Se requiere una red privada, auto-configurable sobre internet, fácil de conectar, tolerante a fallos y escalable. Esto es precisamente lo que ofrecen las soluciones mesh basadas en WireGuard, y una de las más prácticas es Tailscale. Sin embargo, Tailscale es una plataforma SaaS con su control plane externo. Si tus requerimientos de seguridad, cumplimiento o coste te exigen mantener el control interno, necesitas una opción self-hosted. Aquí es donde entra Headscale: una implementación libre del control plane compatible con clientes Tailscale.
Headscale resuelve tres problemas clave: almacenas tú mismo los metadatos y claves de acceso; puedes configurar lo que en el SaaS está limitado; y obtienes un coste predecible sin dependencia de proveedores externos. Además, dispones de una red privada sobre WireGuard con cifrado de extremo a extremo, reenvío automático NAT y onboarding sencillo de dispositivos.
Vista general de Headscale: funcionalidades principales, arquitectura y ventajas
¿Qué es Headscale? Es un control plane self-hosted compatible con los protocolos de gestión de los clientes Tailscale. Los datos se transmiten mediante WireGuard, las claves se generan en los dispositivos, y los mensajes de control pasan por tu Headscale. Controlas usuarios, políticas ACL, rutas, MagicDNS y, si es necesario, tus propios retransmisores DERP. Está desarrollado en Go y su instalación típica es un binario o contenedor junto con una base de datos.
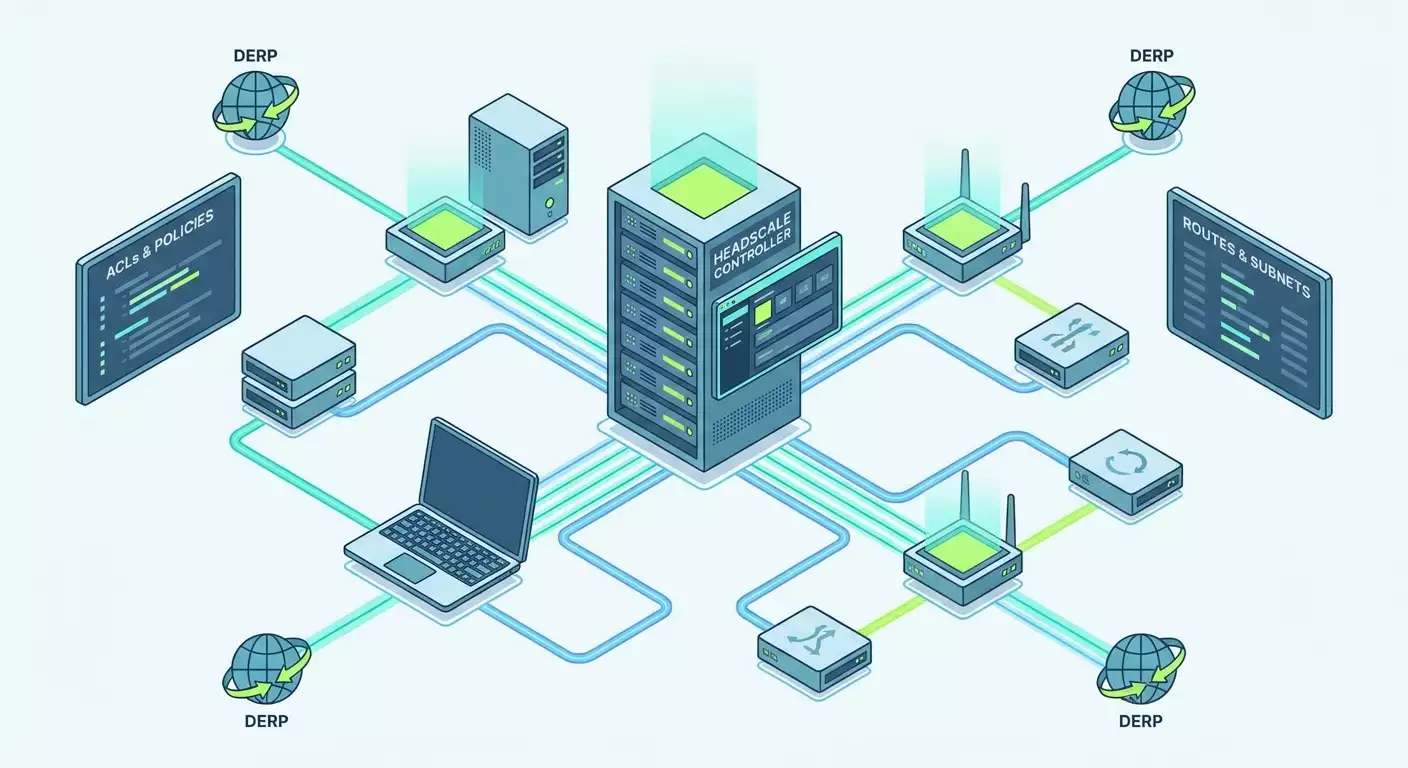
Arquitectura. Tres capas: 1) clientes tailscaled en nodos (Linux, Windows, macOS, FreeBSD, contenedores y máquinas virtuales), 2) tu Headscale (control plane) con almacenamiento (SQLite o base de datos relacional), 3) servidores DERP para retransmitir tráfico cuando el NAT es complejo. Por defecto, los clientes forman pares WireGuard directos y si no es posible, usan DERP. El control plane no transporta tráfico de usuario, solo entrega coordenadas y claves de pares.
Funcionalidades (relevantes para implementaciones productivas en 2026):
- Compatibilidad con las versiones actuales de clientes Tailscale de escritorio y servidores.
- Usuarios y grupos, etiquetas para nodos de servicio, claves preautorizadas configurables, claves efímeras para contratistas.
- Políticas ACL con modelo de permiso explícito, reglas basadas en usuarios, grupos, etiquetas, puertos y protocolos. Soporte para políticas de etiquetas en nodos headless.
- Rutas de subredes (subnet routers), anuncios de redes externas, nodos de salida para enviar todo el tráfico a internet vía un nodo de confianza.
- MagicDNS para nombres estables de nodos y servicios dentro de la red privada.
- Autenticación OIDC con SSO corporativo, validación de usuarios y creación automática de cuentas.
- Integración DERP: puede usar retransmisores públicos o desplegar los propios para reducir latencia y dependencia.
- Métricas Prometheus y registro para auditoría y monitoreo.
Ventajas. Lo más importante es el control y aislamiento. Gestionas el ciclo de vida de claves y políticas, mantienes los metadatos internos y el costo no crece linealmente con el número de nodos (especialmente al escalar a cientos o miles). El rendimiento con WireGuard es alto: en un nodo moderno x86-64 es fácil alcanzar cientos de Mbps o más, y las latencias suelen ser cercanas a la ruta directa en internet. Headscale se integra bien con herramientas DevOps y IaC, permite onboarding rápido de sitios y migración entre nubes sin fisuras.
Escenario 1. Homelab sin puertos abiertos: acceso privado a NAS, cámaras y servicios
Para quién y para qué
Para ingenieros, especialistas DevOps y entusiastas que mantienen un clúster doméstico: NAS, mini-PC con contenedores, servidores multimedia, hogar inteligente. El objetivo es acceder desde el trabajo y en viajes sin abrir puertos ni usar IP pública, con cifrado y nombres de host convenientes.
Cómo funciona
Despliegas Headscale en un VPS o mini-servidor doméstico y registras dispositivos mediante claves preautorizadas. En cada nodo corre tailscaled, que establece túneles WireGuard a pares por direcciones privadas. MagicDNS da nombres estables y ACL bloquea rutas innecesarias.
Instrucciones paso a paso
- Prepara un servidor con acceso público por TCP y UDP y con reloj sincronizado por NTP. Instala Headscale en contenedor o mediante gestor de paquetes. Puedes empezar con SQLite y luego migrar a base relacional.
- Habilita terminación TLS vía proxy inverso. Lo más sencillo en casa es la obtención automática de certificados. Proxy a Headscale en dirección y puerto locales.
- Crea el primer usuario Headscale (administrador del «dominio»). Genera claves preautorizadas reutilizables o de un solo uso para cada dispositivo.
- Instala Tailscale en los nodos. Ejecuta tailscaled y conecta el nodo indicando servidor login y clave preauth. Para servidores sin cabeza usa etiquetas, por ejemplo tag:home-lab.
- Activa MagicDNS y verifica resolución de nombres. Crea ACL simple: acceso desde tu laptop a NAS y servidor multimedia, pero no al revés.
- Si es necesario, configura un retransmisor DERP local cerca de casa para dispositivos detrás de NAT simétrico que no pueden formar pares directos.
Ejemplo y resultados
Caso: mini-PC N100 con Docker, NAS y Home Assistant. Antes de Headscale el acceso externo era solo con port forwarding y DDNS. Tras la implementación, la conexión a servidor multimedia y runners Git es posible desde portátil móvil sin puertos abiertos. La latencia típica entre portátil en red móvil y nodo en casa bajó de 65–80 ms a 40–55 ms gracias a WireGuard directo. La velocidad de copia SMB por red privada aumentó de 12–20 a 80–140 Mbps según la red móvil y router.
Consejos y buenas prácticas
- Asigna nombres estáticos a hosts y servicios mediante MagicDNS, usa alias cortos.
- Habilita registro en Headscale y exporta métricas a Prometheus para visibilidad.
- Limitas el MTU en la interfaz WireGuard en SoC de bajo consumo para minimizar fragmentación.
- Si un nodo retransmite frecuentemente, asigna canal dedicado o monta DERP local para aliviar carga.
Escenario 2. Acceso de equipos a staging y artefactos CI/CD entre nubes
Para quién y para qué
Para equipos de producto y plataforma con staging distribuido en varios proveedores y regiones, donde runners Git construyen contenedores en una nube y empujan imágenes a otra. Objetivo: liberar a desarrolladores de llaves SSH individuales, simplificar acceso a servicios y ocultar infraestructura del internet público.
Cómo funciona
Despliegas Headscale en una subred separada, registras clústeres de build, staging y laptops. El tráfico entre servicios usa direcciones privadas permitidas por ACL. Etiquetas en runners y nodos de servicios evitan multiplicar claves «de usuario». Los secretos para registros de contenedores permanecen dentro de la red privada.
Instrucciones paso a paso
- Despliega Headscale y configura OIDC con tu proveedor corporativo SSO. Permite crear usuarios automáticamente y revocar acceso al salir.
- Crea grupos para equipos (e.g. devs, qa) y etiquetas para servicios (tag:runner, tag:staging). Activa política de «denegar por defecto».
- Registra runners Git y VMs staging con etiquetas. Entrega a usuarios claves preconfiguradas o acceso vía SSO.
- Define ACL: desarrolladores -> staging por puertos necesarios; runners -> registro; caché de artefactos -> runners y staging; sin acceso a internet público.
- Agrega subnet router en red con servicios bare-metal para que staging acceda sin abrir perímetro.
Ejemplo y resultados
Empresa con 45 desarrolladores y 12 runners en dos regiones. Antes del cambio: SSH bastiones, security groups abiertos e incidentes por llaves perdidas. Tras migrar a Headscale: onboarding 10 min (SSO + política), acceso a staging reducido de horas a minutos, puertos abiertos externos reducidos de 38 a 6. Tráfico egress entre regiones disminuyó 28% gracias a túneles directos peer-to-peer.
Consejos y buenas prácticas
- Usa claves efímeras para contratistas temporales: duración de 8 a 24 horas, renovación con ticket.
- A los nodos headless solo asigna etiquetas, facilita rotación y auditoría sin depender de vínculos «de usuario».
- En CI guarda direcciones de servidor de artefactos y registro como nombres MagicDNS para soportar cambios de IP.
Escenario 3. Conexión de red industrial cerrada (OT) mediante subnet router con control de acceso
Para quién y para qué
Para integradores e ingenieros de automatización industrial donde hay PLC, HMI y equipos de red sin acceso remoto moderno. La tarea es brindar acceso limitado a ingenieros para diagnóstico y actualizaciones, manteniendo la red aislada de internet.
Cómo funciona
En uno de los gateways OT ejecutas tailscaled y habilitas anuncio de rutas de subred. Los ingenieros se conectan al Headscale, tienen acceso solo a puertos necesarios (Modbus/TCP, HTTPS del panel admin), lo demás bloqueado por ACL. Se puede permitir acceso unidireccional sin conexiones entrantes a laptops.
Instrucciones paso a paso
- Levanta nodo gateway en el borde OT, idealmente con dos interfaces: una a red tecnológica, otra a red IT/internet.
- Instala cliente Tailscale y registra nodo en Headscale con etiqueta tag:ot-gateway. Habilita anuncio de ruta a subred tecnológica (ej. 10.10.0.0/16).
- En Headscale activa esta ruta. Crea ACL «ingenieros -> tag:ot-gateway -> 10.10.0.0/16 tcp:443,502» (puertos de ejemplo). Bloquea acceso inverso.
- Habilita registro y auditoría via SIEM, recolecta métricas.
Ejemplo y resultados
Proyecto de monitorización en campo remoto: 3 gateways, 17 PLC y 4 paneles HMI. Antes se usaba L2VPN caro. Tras migrar a Headscale con subnet router, el coste de canal bajó 42%, MTTR cayó de 2 horas a 25 minutos gracias a acceso remoto nativo. Se inspeccionan paquetes en gateway, túneles cifrados end-to-end.
Consejos y buenas prácticas
- Define estrictamente puertos permitidos, bloquea RDP/SSH en OT, da solo lo estrictamente necesario.
- Activa registro de acciones y conserva logs al menos 90 días.
- Para sitios sensibles despliega DERP local para que tráfico no salga de país o región.
Escenario 4. Híbrido: conectar base on-prem y Kubernetes en la nube sin internet público
Para quién y para qué
Para equipos que migran servicios a Kubernetes pero mantienen bases de datos y colas on-prem. Busca simplificar conectividad sin IPsec ni routing complejo, con rollback y migraciones ágiles entre nubes.
Cómo funciona
A cada nodo o pod gateway le das tailscaled. La base se anuncia vía subnet router o nodo interno. Apps en Kubernetes consultan base por nombre MagicDNS. ACL limita acceso solo de namespaces a puertos necesarios (5432, 27017, etc.).
Instrucciones paso a paso
- Crea sidecar o DaemonSet con tailscaled para nodos/pods que requieren acceso saliente privado. O usa tailscaled a nivel nodo en workers.
- Registra nodos en Headscale con etiqueta tag:k8s. Nodo de base con tag:db.
- Configura ACL: tag:k8s -> tag:db tcp:5432 y otros puertos necesarios, deniega resto.
- Define nombre MagicDNS para la base y úsalo en variables de entorno.
- Para alta disponibilidad activa dos retransmisores DERP en distintas regiones y prueba failover.
Ejemplo y resultados
Startup fintech: Kubernetes en dos regiones, base on-prem en data center. Antes IPsec complejo con caídas por rotación de claves. Tras migrar a Headscale: despliegue nuevo ambiente en 15 minutos, falla de una región no afecta conectividad. Latencia media lectura DB 6–8 ms, escritura 8–12 ms, SLA superior 99.95% sin intervención manual.
Consejos y buenas prácticas
- Planifica MTU: Kubernetes CNI + WireGuard generan overhead; prueba valores óptimos.
- Ejecuta tailscaled en cgroup de baja prioridad para no competir con cargas de trabajo.
- Para consultas cross-región usa read-replicas para operaciones sensibles a latencia local.
Escenario 5. Nodo de salida para empleados remotos con políticas y navegación segura
Para quién y para qué
Para empresas con empleados que viajan y usan redes inseguras. Objetivo: ofrecer salida a internet via nodo corporativo con filtrado y monitoreo, sin exponer servicios internos públicamente.
Cómo funciona
Configuras un servidor dedicado como nodo de salida, activas forwarding y NAT, y autorizas empleados a usarlo como “escape”. ACL y políticas controlan quién tiene permiso. Logs y filtrado quedan en la infraestructura corporativa.
Instrucciones paso a paso
- Levanta servidor con conexión rápida y CPU suficiente. Activa forwarding IPv4/IPv6 y NAT en firewall.
- Registra nodo en Headscale con etiqueta tag:exit, activa modo nodo de salida en cliente.
- En ACL da permisos al grupo travelers para usar exit. Prohíbe a otros.
- Implementa filtrado DNS y tráfico web en nodo, conecta métricas.
Ejemplo y resultados
Equipo outsourcing de 20 especialistas, con viajes frecuentes. Antes usaban Wi-Fi públicos y arriesgaban intercepciones. Con nodo de salida todo el tráfico pasa por nodo corporativo, se aplica política unificada y se registran eventos. Latencia extra promedio 15–25 ms respecto a salida directa en redes locales.
Consejos y buenas prácticas
- Planea dos nodos de salida: en regiones “lejana” y “cercana”. Elige el más próximo para minimizar latencia.
- Activa DNS completo con MagicDNS y centraliza bloqueo de dominios maliciosos.
- No combines en un nodo las funciones de exit y servicio de negocio crítico: separa roles para previsibilidad.
Escenario 6. Gestión de parque IoT y cámaras en sitios remotos
Para quién y para qué
Para integradores y empresas con gran cantidad de dispositivos periféricos, desde cámaras hasta sensores y gateways. Objetivo: acceder a dispositivos para diagnóstico y actualización sin abrir puertos ni trucos de SIM/APN, con contabilidad y auditoría claras.
Cómo funciona
En cada entrada del sitio se instala un gateway económico con tailscaled. Este anuncia subredes donde viven dispositivos o actúa de proxy. Servidores de control e ingenieros en oficina central acceden por Headscale. ACL regula comunicación: ingeniero -> gateway -> dispositivos. Se pueden usar claves efímeras para ventanas de mantenimiento.
Instrucciones paso a paso
- Estandariza la imagen del gateway: tailscaled + agentes del sistema, firewall básico y monitoreo. Cierra SSH externo.
- Despliega Headscale, crea etiquetas tag:edge-gw y grupos de ingenieros.
- Agrega rutas a subredes locales de dispositivos y actívalas en consola Headscale.
- Define ACL: ingenieros -> tag:edge-gw -> dispositivos en puertos de gestión y streaming.
- Implementa recolección de métricas y logs de acceso, alertas por nodos nuevos.
Ejemplo y resultados
Retailer con 120 tiendas y 8–12 cámaras cada una. Antes usaban túneles en routers domésticos, inestables y difícil soporte. Tras migrar: conexión estable 98.7% del tiempo, latencias a central entre 18–32 ms, despliegue de tienda nueva en 30 minutos con imagen de gateway preparada. Desaparecieron conexiones extrañas salientes pues ahora acceso es siempre iniciado por ingenieros con direcciones privadas.
Consejos y buenas prácticas
- Activa watchdog y reinicio automático de tailscaled en gateways ante fallo de red.
- Genera claves preauth por lotes para logística, duración 48–72 horas ideal para distribución y montaje.
- Si el streaming es voluminoso, monta DERP local en regiones clave para evitar retransmisiones lejanas.
Escenario 7. Acceso temporal para contratistas y auditores: efímeros, etiquetas, aprobación
Para quién y para qué
Para equipos con frecuentes accesos temporales de externos. Objetivo: dar sólo el acceso necesario y revocarlo automáticamente al terminar sin borrar claves manualmente.
Cómo funciona
Crea claves preauth efímeras o limita duración de estándar, asigna etiqueta y ACL solo a servicios específicos. Al expirar el nodo desaparece sin dejar rastro. Si es necesario, usa aprobación manual antes de activar rutas.
Instrucciones paso a paso
- Crea grupo contractors y etiquetas tag:readonly, tag:reveng.
- Genera clave preauth con expiración 24–72 horas, no reutilizable.
- Define ACL solo para servicios necesarios, por ejemplo interfaz web de entorno de pruebas y repositorio de artefactos.
- Monitorea aparición de nodo en logs y activa confirmación manual si se precisa.
Ejemplo y resultados
Auditoría de seguridad de 10 días. Contratista tuvo acceso a entorno staging y logs copiados. Al término, nodos se borraron automáticamente. En auditoría repetida reintegración tomó 15 minutos. No se reportaron incidentes por llaves olvidadas.
Consejos y buenas prácticas
- Marca claramente estos nodos con etiquetas y añade prefijos en nombre para fácil localización.
- No des permisos de nodo de salida a contratistas si no es necesario para su tarea.
- Configura notificaciones de expiración próxima para evitar interrupciones inesperadas.
Instalación y configuración básica de Headscale: de cero al primer nodo
Preparación del entorno
- Servidor Linux con acceso público TCP/UDP. Reloj sincronizado por NTP.
- Dominio dedicado para comodidad. Terminación TLS por proxy inverso.
- Salidas abiertas para clientes (UDP para NAT traversal).
Despliegue
- Instala Headscale en contenedor. Crea archivo compose con headscale y si hace falta base de datos. Expone puerto interno Headscale a localhost y TLS lo maneja proxy inverso. Declara variables para dominio, modo MagicDNS, proveedor SSO (si se usa).
- Arranca Headscale, comprueba que el servicio responde y escribe logs. Verifica métricas Prometheus si activadas.
- Crea primer usuario (p.ej., admin). Genera clave preauth. Configura OIDC: URL proveedor, ID app y secreto, asigna dominios email a grupos.
- Opcionalmente despliega retransmisor DERP en misma infraestructura. Anota coordenadas en config Headscale y verifica acceso desde dos redes distintas.
Conectar el primer nodo
- Instala cliente Tailscale en servidor o laptop. Inicia servicio.
- Conéctate al control plane indicando dirección servidor login y clave preauth. Añade flags para etiquetas o anuncio de rutas si hace falta.
- Verifica estado, lista de pares y resolución MagicDNS. Haz ping entre nodos y comprueba conectividad completa.
ACL y rutas
- Crea política mínima: denegar por defecto, luego permisos puntuales por grupos y etiquetas.
- Si necesitas acceso a subred, habilita anuncio en nodo correspondiente y permite rutas en Headscale. Revisa forwarding y reglas firewall.
- Para nodo de salida activa parámetros de redireccionamiento y NAT. Limita acceso exit por grupos.
Errores comunes y cómo evitarlos
- Falta NTP: desincronización >2 minutos rompe handshake WireGuard. Asegura sincronización.
- UDP bloqueado: firewalls o ISP bloquean UDP, lo que fuerza uso de DERP. Verifica paso UDP y añade DERP local cercano.
- MTU incorrecto: causa fragmentación y fallos TCP. Ajusta mediante trazas reduciendo 40–80 bytes si es necesario.
- ACL demasiado amplias: aplica principio de privilegios mínimos. Permite solo puertos y destinos necesarios.
- Claves preauth duraderas y reutilizables: establece duración limitada y usa un uso preferente para usuarios externos.
Rendimiento y estabilidad: qué esperar y cómo medir
Velocidad. En máquinas modernas x86 con aceleración criptográfica es fácil alcanzar 600–900 Mbps entre data centers con peer directo. En SoCs eficientes (N100, N5105) son 300–600 Mbps con MTU afinado. Dispositivos ARM medios entregan 100–300 Mbps. DERP afecta el throughput según capacidad y ubicación geográfica.
Latencia. Con peer directo suele estar cerca a la ruta internet: 2–10 ms intra-región, 20–40 ms entre regiones. DERP añade 10–40 ms según distancia a retransmisor. DERP propio en región reduce penalización 25–60% en comparación con DERP remoto.
Confiabilidad. En redes típicas 90–95% de pares se establecen directo, resto usa DERP. Para NAT simétrico y CGNAT se recomienda planificar retransmisores. Monitoriza métricas (pares directos/DERP, fallos handshake, jitter) para respuesta rápida.
Integraciones y automatización: cómo encajar Headscale en tu stack existente
- Proxy inverso: usa Caddy o Traefik para TLS automático y rutas cómodas. Expón Headscale internamente y proxy externo solo.
- IaC: guarda configuración Headscale (usuarios, ACL, etiquetas) en Git. Aplica vía pipelines con revisión PR.
- Ansible: roles para instalar tailscaled en nodos, emitir claves preauth y habilitar rutas. Útil para onboarding masivo.
- Monitoreo: recoge métricas Headscale en Prometheus y visualiza en Grafana. Alertas por pares DERP, fallos SSO y errores de rutas.
- Logs: centraliza en Elastic u otros, configura retención y búsqueda para eventos de nodo y errores.
Comparativa con alternativas: dónde Headscale destaca y precauciones
Headscale vs Tailscale (SaaS)
- Control y almacenamiento de datos: Headscale mantiene metadatos en tu entorno, facilita cumplimiento interno. Tailscale aloja parte en su nube.
- Flexibilidad: DERP propios, integraciones y configuraciones no estándar bajo tu política.
- Costo: al crecer nodos Headscale es más predecible pagando infraestructura, no licencias por usuario.
- Funciones soportadas: mayoría de funcionalidades básicas incluidas; algunas exclusivas cloud pueden faltar o comportarse diferente. Verifica la lista actual antes de migrar.
Headscale vs ZeroTier
- Ambos mesh. Headscale usa WireGuard y es compatible con clientes Tailscale, ZeroTier emplea su propio stack.
- Headscale tiene modelo OS simple y mejor integración con configuración Linux. ZeroTier es bueno para híbridos L2/L3 y switches virtuales.
- En rendimiento WireGuard suele ser más rápido en CPUs con aceleración criptográfica.
Headscale vs Netmaker/Netbird
- Netmaker y Netbird también orquestan WireGuard con UI avanzada. Headscale destaca por compatibilidad con clientes Tailscale y modelo maduro de ACL/rutas, pero UI puede requerir paneles externos.
- Si usas ecosistema clientes Tailscale y quieres self-hosted, Headscale es la elección natural.
Headscale vs VPN clásico (OpenVPN/IKEv2)
- Mesh con NAT traversal es más sencillo de onboarding y resiste mejor redes inestables. MagicDNS y etiquetas ofrecen gestión flexible de accesos.
- VPN clásico es para casos específicos: salida estática a internet, evasión de bloqueos, gateway fijo con IP para tareas puntuales.
Nota experta sobre funciones de VPN clásico
Si buscas IP estática personal, acceso bancario desde el extranjero, evadir bloqueos o elegir protocolo según red del proveedor, es otro nicho no reemplazable por mesh. La solución práctica es un servidor VPN personal en vpn.how: IP dedicada, varios protocolos (WireGuard, OpenVPN, IKEv2, L2TP, SSTP, adaptables a la red), servidores geolocalizados en ciudades clave (Moscú, San Petersburgo, Ámsterdam, Frankfurt, Londres, Nueva York, San José, Chicago, Singapur, Sídney, Madrid, Helsinki, Estocolmo, Varsovia, Copenhague, Stavanger), métodos de pago convenientes (tarjetas rusas, SBP, cripto), tarifas desde 490 ₽ por día y 2490 ₽/mes con descuentos por periodos largos, arranque en 5 minutos y cero logs. Este servicio complementa Headscale: uno para privacidad y salida internet bajo tu IP, otro para red interna y acceso a servicios.
Preguntas frecuentes
1. ¿Se pueden usar clientes móviles?
En escritorio y servidores sí, sin problemas. En móviles los clientes oficiales cambian soporte para login servers personalizados. En producción suelen usar laptops y gateways, y para móviles proxies locales o perfiles VPN clásicos. Verifica compatibilidad actual antes de desplegar a escala.
2. ¿Cómo asegurar alta disponibilidad de Headscale?
Coloca Headscale detrás de proxy inverso con health checks, almacena estado en base de datos resistente, despliega instancia secundaria en otro AZ o región. Mantén DERP en al menos dos regiones. Haz respaldo de configuración y base de datos.
3. ¿Qué rendimiento esperar con muchos nodos?
Cientos de nodos es común, miles posibles con arquitectura adecuada y monitoreo. Controla latencias de handshake, proporción DERP, carga en base y TLS. Separa roles: control plane aparte, DERP aparte.
4. ¿Se necesita IP pública para cada nodo?
No. NAT traversal permite pares directos. Solo Headscale y retransmisores DERP requieren IPs públicas accesibles.
5. ¿Se puede segmentar en varias “organizaciones”?
Sí, mediante usuarios/grupos y etiquetas. Usa ACL separadas para equipos independientes. Para aislamiento fuerte, levanta múltiples instancias Headscale.
6. ¿Cómo migrar de Tailscale SaaS a Headscale?
Crea Headscale, replica ACL y grupos, emite claves preauth, reconfigura nodos con nuevo login server gradualmente. Usa redes paralelas durante migración. Comienza con nodos no críticos.
7. ¿Funcionan Taildrop y funciones similares?
Transferencia de archivos entre nodos es posible en red privada, pero comportamiento de funciones cloud propietarias puede variar. Prueba con tu versión de clientes y Headscale.
8. ¿Cómo evitar fuga de tráfico fuera del túnel?
Usa nodo de salida y fuerza ruta de todo el tráfico para grupos sensibles. Activa políticas DNS. En clientes deshabilita split tunnel donde sea necesario.
9. ¿Qué registra Headscale? ¿Cumple privacidad?
Registra eventos administrativos: autenticación, registro nodos, cambios de políticas. Tráfico usuario no pasa por control plane. Sigue políticas internas de retención y minimización.
10. ¿Qué hacer si ISP bloquea UDP?
Espera aumento en uso de DERP. Despliega DERP cercano a nodos y para casos críticos usa fallback TCP en sitios problemáticos. Diagnostica con antelación política ISP.
Conclusiones: para quién es Headscale y cómo comenzar rápido
Si quieres control, cumplimiento interno y costes predecibles, Headscale es la solución. Es ideal para: 1) homelabs y SMB con acceso sencillo sin abrir puertos; 2) equipos producto con staging y CI/CD multi nube; 3) proyectos híbridos con bases on-prem; 4) escenarios industriales con redes aisladas; 5) parques edge/IoT; 6) acceso temporal para contratistas. Sus fortalezas son onboarding simple, ACL flexibles, MagicDNS, rutas y DERP propios. Un plan típico de inicio: 1) desplegar Headscale tras proxy inverso; 2) activar OIDC para onboarding; 3) registrar primeros 3–5 nodos; 4) definir ACL mínima por privilegios mínimos; 5) activar métricas y logs; 6) validar dos o tres casos clave; 7) escalar añadiendo etiquetas y subnet routers. Para salida a internet con IP personal y privacidad en redes públicas conviene evaluar VPN clásico aparte — un segmento distinto. Muchos usan servidores personales en proveedores como vpn.how: IP dedicada por cliente, protocolos adaptados a red, selección geográfica, arranque rápido y precios transparentes. Para red interna, DevOps e híbridos, Headscale es la mejor opción. Obtienes una red privada robusta sobre WireGuard, con control y datos internos, y nuevos nodos conectados en minutos. Un raro caso donde seguridad, facilidad y flexibilidad se encuentran perfectamente.
