NetBird vs Tailscale: nueva plataforma para equipos — análisis y casos prácticos 2026
Análisis profundo de NetBird y Tailscale en 2026: cómo elegir, ventajas de las redes mesh VPN, 7 escenarios prácticos con instrucciones paso a paso, errores comunes, consejos útiles y comparación con alternativas. Recurso para ingenieros y líderes de seguridad.
Contenido del artículo
- Introducción: qué problema resuelve el mesh vpn moderno
- Análisis: fortalezas de netbird y tailscale en 2026
- Escenario 1. acceso de desarrolladores a staging y producción sin interrumpir el pipeline
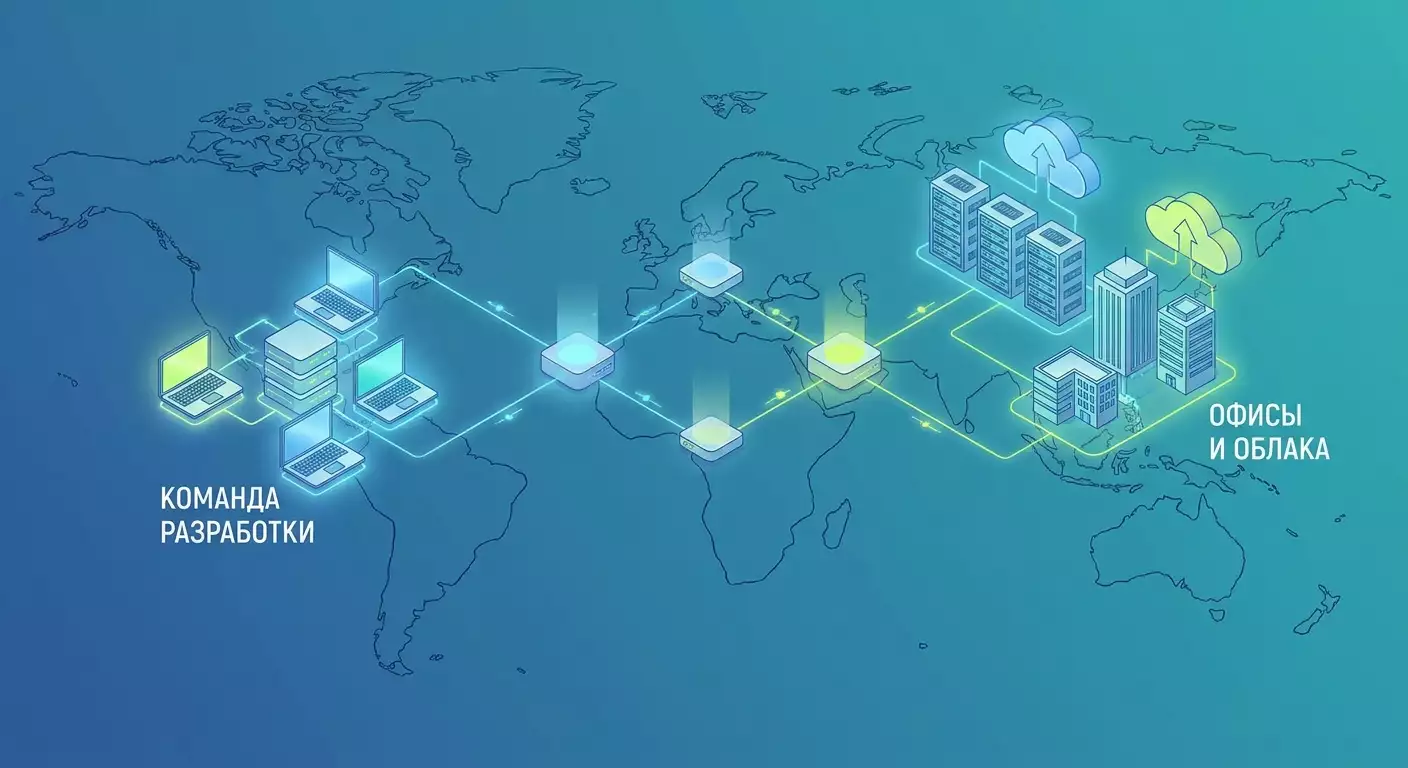
- Escenario 2. conectar oficinas y nubes sin un site-to-site clásico
- Escenario 3. contratistas y accesos temporales sin riesgo de reglas "pegajosas"
- Escenario 4. kubernetes, contenedores y ci/cd: canales seguros sin abrir puertos
- Escenario 5. self-hosting y requisitos regulatorios
- Escenario 6. laboratorios caseros, medios y iot sin internet abierto
- Escenario 7. acceso de emergencia y recuperación: plan "b" como código
- Comparación con alternativas: cuándo netbird, cuándo tailscale y qué más hay
- Faq: preguntas prácticas 2026
- Conclusiones: para quién son netbird y tailscale y cómo empezar rápido
Actualizado: 2026. Estamos acostumbrados a los VPN "tradicionales": montamos un servidor, otorgamos acceso, configuramos el enrutamiento — y listo. Pero los equipos distribuidos, la nube, los contratistas y las cadenas complejas de CI/CD convierten al VPN tradicional en un cuello de botella: rehacer redes y ACL para cada nueva integración es costoso y lento. Aquí llegan las plataformas mesh VPN basadas en WireGuard, especialmente NetBird y Tailscale. En este artículo, analizaremos sus diferencias, en qué casos realmente ahorran semanas de trabajo y presentaremos 7 escenarios prácticos con instrucciones detalladas y resultados.
Introducción: qué problema resuelve el mesh VPN moderno
El VPN clásico se basa en un gateway centralizado y un espacio de direcciones. Cuando hay más de una docena de usuarios y ubicaciones, surge deuda técnica acumulativa: conflictos IP, ACL estáticas, capacidad limitada del gateway, altos RTO en fallas. El enfoque mesh lo aborda distinto: cada dispositivo es un nodo de red P2P, las claves y políticas se asignan automáticamente y el tráfico va directo entre participantes o via relay cuando hay NAT complejo. Las reglas de acceso se definen por identidad, grupos y servicios, no por subredes "grisáceas". Obtienes un paradigma Zero Trust sin rehacer toda la topología de red.
En 2026 dominan dos enfoques: Tailscale como "producto-servicio con mínima barrera de entrada" y NetBird como alternativa "open source, fácil de self-hostear" con políticas sofisticadas y flexibilidad. Ambas plataformas usan WireGuard y señalización moderna para sortear NAT. En la práctica, la diferencia es filosofía: velocidad y comodidad versus control y escalabilidad.
Análisis: fortalezas de NetBird y Tailscale en 2026
Aspectos comunes:
- Túneles WireGuard entre pares, cifrado de extremo a extremo, alto rendimiento en hardware modesto.
- NAT traversal: intentos automáticos de conexión directa y fallback a relay si es necesario.
- Identidad a nivel de dispositivos y usuarios con SSO: Okta, Azure AD, Google Workspace, etc. Políticas basadas en grupos, etiquetas y atributos.
- ACL, enrutamiento de subredes, gestión DNS, auditoría de claves y eventos.
Qué destaca en Tailscale:
- Arranque en minutos con mínima configuración. Comandos como "tailscale up", MagicDNS automático, Tailscale SSH integrado, intercambio de archivos y túnel HTTP vía Tailscale Funnel.
- Plano de coordinación en la nube listo para usar. Soporta Headscale para self-hosting flexible del control plane.
- Amplio ecosistema de integraciones y clientes para todos los SO, incluyendo móviles y contenedores.
Qué destaca en NetBird:
- Código abierto del núcleo y capacidad de self-host completo (servidor de gestión, señalización, coordinación, relay). Transparencia y extensibilidad para escenarios regulatorios.
- Motor de políticas flexible con atributos, roles y contexto del dispositivo: fácil de expresar matrices de acceso complejas sin ACL rígidas.
- Escenarios de enrutamiento e integración con redes existentes, soporte para comprobaciones posturales y manejo nativo de rutas Multi-Cloud.
Conclusión: para pequeñas y medianas empresas, Tailscale es un método instantáneo para organizar accesos sin costos administrativos. Para compañías con fuertes requerimientos de control, personalización y self-hosting, NetBird es la opción preferida. Pero la elección depende de la tarea. A continuación, escenarios prácticos donde esas diferencias son evidentes.
Escenario 1. Acceso de desarrolladores a staging y producción sin interrumpir el pipeline
Para quién y por qué
Equipos de desarrollo y SRE con acceso a entornos staging, preview y acceso restringido a producción bajo el principio de mínimos privilegios. El objetivo es simplificar acceso y auditoría sin afectar la velocidad de lanzamientos.
Cómo usarlo
- Define grupos de acceso: Dev, QA, SRE, SoloLectura.
- Integra la plataforma con tu SSO (Okta, Azure AD, Google Workspace). Incluye atributos en la política: departamento, proyecto, nivel de acceso.
- Describe permisos como reglas de Servicio a Identidad: «Dev → staging.*:22,443», «SRE → prod.db.*:5432», «QA → preview.*:80,443».
- Configura MagicDNS (Tailscale) o DNS gestionado (NetBird) para que los servicios tengan nombres estables: «staging-api.local», «prod-db.local».
- Instala clientes en laptops y agentes de CI, asigna dispositivos a grupos. Habilita comprobaciones posturales: cifrado de disco, presencia de EDR.
Ejemplo paso a paso: Tailscale
- Instala el cliente: «curl -fsSL ... | sh» y «tailscale up --login-server=
--ssh». - En admin crea grupos «dev», «sre». Configura ACL JSON: permite dev acceso a 10.0.10.0/24 (staging) en puertos 22,443; sre a 10.0.20.10:5432 (prod-db) y 10.0.20.0/24 en 443.
- Activa Tailscale SSH para nodos staging, limitando logins según grupos. Añade expiración para accesos jump temporales.
Ejemplo paso a paso: NetBird
- Despliega NetBird Management (en cloud o self-host). Conecta IdP vía OIDC, importa grupos.
- Instala agentes: «netbird up --setup-key=...». Las políticas se aplican según grupos.
- Crea Policy: Subject=Group:Dev, Resource=Tag:Staging, Actions=SSH,HTTPS. Para producción, una policy separada con reglas más estrictas y permisos temporales.
Resultados en números
- Reducción del MTTA (tiempo promedio para acceso) para desarrolladores nuevos de 1-2 días laborales a 30-60 minutos.
- Hasta un 70% menos consultas a soporte por acceso VPN gracias al mapeo automático de grupos y atributos SSO.
- Auditoría precisa de accesos: no decenas de reglas IP en firewall, sino un historial claro de quién, cuándo y a qué servicio se conectó.
Consejos útiles
- No mapees subredes antiguas tal cual. Comienza con nombres de servicios y DNS.
- Activa la eliminación automática de claves tras offboarding en IdP para evitar claves "olvidadas".
- Para accesos temporales usa tokens con expiración y política break-glass con confirmación extra.
Escenario 2. Conectar oficinas y nubes sin un site-to-site clásico
Para quién y por qué
Empresas medianas y startups en rápido crecimiento con varias oficinas, data centers y nubes. Objetivo: construir enrutamiento L3 flexible sin inversiones en MPLS, IPsec ni planos de control complejos.
Cómo usarlo
- Elige nodos regionalmente cercanos como "enrutadores de subred": oficinas, VPC, nodos on-prem.
- Agrega anuncios de rutas: LAN oficina 192.168.10.0/24, VPC 10.2.0.0/16, DC 172.16.0.0/16.
- Define rutas preferentes y respaldo: principal por peering directo, respaldo por relay.
- Configura split-DNS para dominios internos: «corp.local», «eu.corp» con sus resolvers correspondientes.
Pasos en Tailscale
- En host router: «tailscale up --advertise-routes=192.168.10.0/24,10.2.0.0/16».
- Aprueba rutas en admin. Activa «exit node» si quieres enrutar tráfico internet por allí.
- Configura DNS: MagicDNS y resolvers por dominio para «corp.local».
Pasos en NetBird
- Asigna un nodo como «Gateway» para cada ubicación.
- Agrega rutas y filtros de acceso por grupos en Policy.
- Configura métricas de preferencia y fallback vía UI/CLI.
Caso y resultados
Empresa de 180 empleados unió 2 oficinas y 3 VPC cloud. Implantación en 4 días frente a 3-4 semanas antes con IPsec clásico. Latencia promedio entre oficina y nube bajó de 58 ms a 34 ms gracias a peering directo. SLA alcanzó 99.96% por fallback automático en cuellos de botella. Reconfigurar ruta para nuevo VPC tomó 15 minutos.
Consejos útiles
- Verifica conflictos de subredes con anticipación. Si hay, usa NAT en gateway o redirecciona servicios vía DNS.
- Monitorea MTU. Cuando encapsulas WireGuard, un MTU seguro de 1280-1320 evita fragmentación.
- Guarda esquema de rutas como código: políticas JSON/YAML bajo revisión Git.
Escenario 3. Contratistas y accesos temporales sin riesgo de reglas "pegajosas"
Para quién y por qué
Proyectos de outsourcing y socios, auditores, equipos de pentesting. Objetivo: otorgar y revocar accesos limitados rápidamente sin limpiar firewalls ni borrar cuentas manualmente.
Cómo usarlo
- Crea grupo «Contractors» con atributos obligatorios: MFA, cifrado de disco.
- Da acceso vía token con TTL de 7-30 días. Permite solo puertos y servicios necesarios.
- Activa auditoría detallada: quién, desde dónde, qué y con qué resultado accedió.
Pasos en Tailscale
- Genera claves reutilizables con expiración. En policy bloquea acceso a segmento prod crítico, solo hosts permitidos.
- Activa Tailscale SSH con acceso restringido al grupo «Contractors» y limitación de comandos (mediante políticas SO).
Pasos en NetBird
- Crea Setup Key "one-time" con TTL. Añade Policy para recursos «preview» y «test».
- Conecta auditores a dashboards de solo lectura vía HTTPS con mutual TLS en agente (verificación adicional).
Resultados
- Reducción en tiempo para otorgar acceso a contratistas de 1-2 días a 30-90 minutos.
- Cero reglas "olvidadas" tras fin de trabajos gracias a TTL y revocación automática vía IdP.
Consejos útiles
- Verifica que el contratista no tenga clientes paralelos con redes en conflicto. Si hay, usa VMs o contenedores aislados.
- Limita velocidad y conexiones simultáneas cuando se manejen datos sensibles.
Escenario 4. Kubernetes, contenedores y CI/CD: canales seguros sin abrir puertos
Para quién y por qué
Ingenieros de plataforma y equipos DevOps que conectan builders, clusters y repositorios de artefactos sin exponer firewalls externos. Objetivo: simplificar entrega de artefactos, debugging y acceso a registries internos, Grafana, Tempo, MinIO, etc.
Cómo usarlo
- Despliega agente de red como daemonset/sidecar (Tailscale Operator o agente NetBird), conecta clusters a red mesh única.
- Resuelve servicios vía MagicDNS o función similar en NetBird; publica solo endpoints necesarios.
- Ejecución de runners CI con cliente mesh VPN y claves temporales para duración del build.
Pasos en Tailscale
- Instala Tailscale Operator en cluster. Anota servicios: «tailscale.com/expose=80» para exposición limitada dentro del tailnet.
- Para CI, usa «tailscale up --authkey=tskey-ephemeral-...». Clave expira al acabar job.
Pasos en NetBird
- Despliega agente NetBird como daemonset. Convierte etiquetas de pods en tags de recursos.
- En Policy define qué grupos pueden acceder a «k8s:monitoring», «k8s:registry», «k8s:debug».
Caso y resultados
Equipo de 35 ingenieros redujo tiempo de abrir y acordar puertos de 2-3 días a 0. Producto final con 12% más productividad por peering directo entre runners y registry. Incidentes por puertos abiertos temporalmente a Internet: 0 en seis meses.
Consejos útiles
- Usa claves efímeras de CI solo durante el job. Guárdalas con TTL corto en secretos.
- No sobreexpongas la API de Kubernetes. Para debugging, usa túneles a node/pod limitados por grupo de acceso.
- Agrupa logs de acceso mesh y auditoría k8s en un SIEM para correlación cruzada.
Escenario 5. Self-hosting y requisitos regulatorios
Para quién y por qué
Organizaciones con requisitos estrictos de control de datos, aislamiento del plano de control y auditorías externas (ISO 27001, SOC 2, normativas locales). Objetivo: conservar beneficios de mesh con control total sobre infraestructuras.
Cómo usarlo
- Define qué mantener on-prem: coordinador, señalización, relay, métricas y logs.
- Despliega componentes en esquema de alta disponibilidad: mínimo dos regiones/sedes, healthchecks, claves de respaldo.
- Restringe acceso a la gestión vía bastión y RBAC estricto, activa logs inmutables.
Pasos en NetBird
- Despliega NetBird Management y Signal Server. Activa alta disponibilidad, replicación de bases y claves.
- Configura servidores relay privados y bloquea relay externos por políticas.
- Integra IdP con OIDC/SAML y habilita SCIM para gestión de ciclo de vida de credenciales.
Pasos en Tailscale (con Headscale)
- Instala Headscale como plano de coordinación self-host.
- Conecta nodos con «tailscale up --login-server=
». - Organiza relay/DERP propios por región según necesidad.
Resultados
- Aprobación de auditorías externas con mínimos hallazgos en control de claves y gestión de componentes.
- Reducción en tiempo de análisis de incidentes de 3 días a pocas horas gracias a logs centralizados e inmutables.
Consejos útiles
- Documenta el esquema de trust boundary. El self-host no garantiza seguridad sin RBAC y procesos cuidadosos.
- Guarda claves maestras en HSM o al menos en KMS con separación de funciones.
Escenario 6. Laboratorios caseros, medios y IoT sin internet abierto
Para quién y por qué
Ingenieros, equipos de soporte, estudios multimedia. Necesitan controlar NAS, Home Assistant, entornos de prueba y servidores multimedia desde cualquier lugar sin abrir puertos.
Cómo usarlo
- Instala agentes en servidores y dispositivos domésticos, asigna etiquetas «lab», «media», «iot».
- Permite acceso solo a personas y servicios necesarios: interfaces web en 443, SSH y RDP bajo demanda.
- Para compartir demos temporales usa túnel HTTP incorporado o asigna un nodo internet controlado.
Tailscale
- Orange Pi/NUC como nodo: «tailscale up». Nombres vía MagicDNS: «nas.lab», «ha.lab».
- Usa Tailscale Funnel para publicación web temporal segura sin exponer puertos.
NetBird
- Conecta etiquetas «lab», «iot» con grupos de acceso. Define DNS con resolver integrado.
- Restringe cámaras y dispositivos ruidosos por horarios y grupos.
Resultados
- Adiós a DNS dinámico y apertura de puertos, superficie de ataque casi nula.
- Acceso rápido desde cualquier red, incluso Wi-Fi corporativos restrictivos, sin configuraciones adicionales.
Consejos útiles
- Segmenta IoT y medios por grupos. No des "todo para todos"; es cómodo pero inseguro.
- Controla bitrate de streaming si la conexión es mixta (Wi-Fi + mesh) aplicando límites QoS.
Escenario 7. Acceso de emergencia y recuperación: plan "B" como código
Para quién y por qué
Cualquier organización con servicios críticos. Objetivo: garantizar acceso a SRE y SecOps incluso ante fallas parciales de enlaces, IdP o proveedor cloud.
Cómo usarlo
- Prepara credenciales break-glass en grupo separado con MFA independiente y claves offline. Limita acceso a nodos jump definidos.
- Despliega relay y coordinadores en distintas regiones. Realiza simulacros de falla de canal principal regularmente.
- Documenta procedimientos DR como código y checklist: quién y cómo activa acceso de emergencia, límites y auditoría.
En Tailscale
- Guarda claves offline con TTL corto en un vault seguro. Para emergencias usa «tailscale up --authkey=... --ssh» con limitación por grupos.
- Configura regiones DERP adicionales para mantener acceso pese a bloqueos.
En NetBird
- Relay y management independientes en regiones/data centers separados. Separa roles de operadores.
- Usa políticas que permitan acceso solo a nodos iniciales de recuperación.
Resultados
- Reducción del tiempo para restaurar acceso a producción ante falla de red principal de 2 horas a 15-20 minutos.
- Aprobación de auditoría DR con logs claros y registros de acciones.
Consejos útiles
- Prueba escenarios de emergencia trimestralmente. Personas reales, dispositivos reales, cambio real de contraseñas.
- Separa permisos de emergencia. Nadie debe tener acceso completo absoluto.
Comparación con alternativas: cuándo NetBird, cuándo Tailscale y qué más hay
ZeroTier
Plataforma P2P robusta con modelo propio de direccionamiento y control. Ideal para entornos heterogéneos e IoT. Pero si tu equipo ya trabaja con WireGuard y prefiere ACL basadas en identidad con SSO inmediato, Tailscale o NetBird resultan más simples.
Cloudflare WARP/Teams
Solución excelente para acceso cliente a aplicaciones web y proxy Zero Trust. Si buscas acceso L3 entre servicios y peering directo, el mesh basado en WireGuard ofrece menor latencia y rendimiento más predecible, sobre todo con carga east-west alta.
VPN clásicas OpenVPN/IPsec
Conocidas, predecibles, soportadas "out-of-the-box" en muchos dispositivos. Pero manejar ACL y escalar a docenas de sitios y cientos de nodos es caro en tiempo y recursos humanos. Mesh reduce la complejidad, haciendo el acceso claro y controlable.
Por qué Tailscale
- Mínimo tiempo para arrancar: demo lista en horas para mostrar a negocio.
- Funcionalidades prácticas para desarrolladores: SSH, MagicDNS, comandos CLI simples.
- Ideal para equipos pequeños y medianos sin necesidad de self-host completo.
Por qué NetBird
- Transparencia y flexibilidad: código abierto, self-host para control y cumplimiento.
- Políticas finas y reglas basadas en atributos para matrices de acceso complejas.
- Encaja fácilmente en infraestructuras con fuertes regulaciones y relay propios.
Cuándo un servidor VPN personal es adecuado y por qué no reemplaza al mesh
vpn.how ofrece servidores VPN personales con una IP dedicada. Las ubicaciones, los protocolos y los precios disponibles se muestran en el sitio y en tu cuenta. Los métodos de pago y el importe final aparecen al pagar. Elegir un servidor
FAQ: preguntas prácticas 2026
1. ¿Qué latencia esperar respecto a conexión directa?
Con peering directo la sobrecarga es mínima, unos pocos milisegundos. Con relay, la latencia crece sumando ida y vuelta al nodo relay. En la mayoría de escenarios de oficina, el RTT total está entre 20-50 ms por región.
2. ¿Qué hacer si no se establece peering tras CGNAT y SIM?
Ambas soluciones intentan atravesar NAT. Si no logran, el tráfico pasa por relay. Para canales críticos, asigna un nodo con IP pública como router de subred o despliega relay cerca del borde.
3. ¿Se puede enrutar todo el tráfico a internet por un "exit node"?
Sí. Tanto en Tailscale como NetBird puedes definir un nodo como salida y dirigir tráfico internet por él. Controla políticas, logs y capacidad: se convierte en punto de concentración.
4. ¿Cómo resolver conflictos de subredes entre sitios?
Evitar es lo mejor. Si hay conflicto, utiliza NAT en gateway mesh, renombra servicios con alias DNS y reequilibra subredes gradualmente si es posible.
5. ¿Qué pasa con IPv6?
Ambas plataformas soportan escenarios dual stack. IPv6 facilita peering, pero planifica políticas simétricas para v4 y v6 para evitar "evasiones".
6. ¿Se pueden usar tokens hardware y comprobaciones posturales?
Sí. Mediante IdP y políticas: exige MFA, verifica cifrado disco, EDR, versión SO. En NetBird es configurable en política de cumplimiento; en Tailscale, por integraciones y ACL con filtro por dispositivo.
7. ¿Cuántos nodos soporta la plataforma?
Cientos y miles son escalas comunes. En despliegues grandes, planifica varios relay, segmenta reglas y guarda configuraciones como código para evitar demoras en aplicar políticas.
8. ¿Cómo depurar problemas de red?
Prepara un entorno mínimo reproducible: dos nodos, un servicio, un puerto. Revisa MTU, fuerza cambio de relay, captura pcap antes y después del túnel. Compara políticas de grupos y permisos DNS.
9. ¿Existe riesgo de "bloquearse" con nuevas ACL?
Sí. Administra ACL con borradores, valida sintaxis, aplica gradualmente y mantiene acceso emergencia separado. Añade regla inmutable "grupo admin → nodos mgmt" como base.
10. ¿Cómo migrar suavemente de IPsec/OpenVPN clásico?
Enfócate en servicios y no en subredes. Empieza con dev/staging y CI, luego parte de prod. Mantén canal viejo como respaldo hasta completar tests de carga y DR en mesh.
Conclusiones: para quién son NetBird y Tailscale y cómo empezar rápido
Si buscas ganancia rápida en comodidad y velocidad, elige Tailscale. Necesitas SSH listo, MagicDNS, comandos simples y mínima configuración, tendrás valor el mismo día. Si priorizas control, stack abierto, self-host y políticas refinadas, opta por NetBird. Es ideal donde la regulación exige control propio y modelo atributivo extendido.
Cómo comenzar en 1-2 días:
- Define 2-3 casos de negocio con mayor dolor: acceso Dev a staging, CI a registry, oficina a VPC.
- Pilotea con 10-20 nodos. Conecta IdP, crea grupos, describe 3-5 reglas de acceso.
- Realiza pruebas de carga y DR: peering directo, relay, caída de nodo y región.
- Documenta política como código. Prepara plan de escalado y procesos offboarding.
El secreto del éxito: no intentes portar tu red "tal cual" a la nueva plataforma. Modela accesos sobre identidad, servicios y nombres. Usa pequeñas iteraciones, auditoría y logs inmutables. Recuerda las limitaciones del mesh: si quieres IP saliente personal y evitar bloqueos, opta por servidor VPN personal; para unir equipos e infraestructura bajo Zero Trust, elige entre NetBird y Tailscale según procesos, cumplimiento y escala.
Editor: vpn.how