Balanceo de VPN sin interrupciones: algoritmos, health checks y escalabilidad en 2026
Balanceo de carga para servidores VPN en 2026: algoritmos, health checks, persistencia de sesión, escalabilidad y resiliencia. Consejos prácticos, métricas y casos de WireGuard, OpenVPN, IPsec y Anycast para una infraestructura VPN estable.
Contenido del artículo
- ¿por qué balancear vpn y por qué es importante en 2026?
- Patrones arquitectónicos de balanceo para vpn: de l4 a anycast
- Algoritmos de balanceo: desde simples a avanzados
- Health checks y monitoreo: miramos calidad del túnel, no solo puerto
- Persistencia de sesión para vpn: cómo “pegar” al cliente bien
- Escalar vpn: vertical, horizontal y autoescalado inteligente
- Seguridad y resiliencia: ddos, zero trust y cumplimiento
- Escenarios prácticos y plantillas para openvpn, wireguard e ipsec
- Métricas, slo y economía: cómo saber que todo funciona
- Errores y antipatrón más comunes
- Plan paso a paso para implantar balanceo en vpn
- Casos prácticos: qué funcionó y qué no
- Checklist antes de producción: ¿no olvidamos nada?
- Faq: preguntas frecuentes sobre balanceo vpn
¿Por qué balancear VPN y por qué es importante en 2026?
VPN ya no es solo "teletrabajo", sino una red crítica
Hace pocos años, la VPN en las empresas se veía como una herramienta para trabajo remoto y acceso a sistemas internos. Hoy es distinto. En 2026, la VPN es el transporte para Zero Trust, nubes híbridas, entornos de desarrollo, acceso a clústeres de IA y puntos edge. Antes, si un servidor caía, era molesto, pero ahora, incluso un minuto de inactividad interrumpe la CI, rompe transacciones y afecta el NPS. El balanceo de carga para servidores VPN deja de ser una "opción". Es el pilar de tu fiabilidad de red.
¿Por qué aumentó la carga? Vemos tráfico en tiempo real de soporte por video, telemetría IoT, sincronización de datos para inferencias LLM en el borde. Y sí, VPN dejó de ser "solo para TCP": WireGuard e IPsec corren sobre UDP y requieren un enfoque diferente para health checks, redirecciones NAT y preservación de sesiones. Vivimos rápido, escalamos sin pánico. ¿O no?
La idea clave es simple: sin una correcta distribución de solicitudes entre nodos VPN, chocarás con límites de CPU, EPOLL, sockets y tablas de estado. El balanceador es el director de orquesta de tu VPN, que evita que las tuberías desafinen y mantiene el ritmo bajo carga pico.
Síntomas típicos de sobrecarga que probablemente ya viste
Seguro has visto estas escenas: el ping de usuarios salta y la capacidad disminuye en horas pico. El CPU de algunos nodos se dispara a 90-100%, mientras que otros están inactivos. Quejas de reconexiones constantes, peers WireGuard "desaparecen" por minutos, y logins en OpenVPN se retrasan por timeouts en handshakes TLS. Ahí está la mala distribución, un nodo carga todo el trabajo y los demás aburridos.
Agrega ataques DDoS por UDP, picos repentinos tras lanzamientos o inicio de jornada laboral, rutas cambiantes en topologías multi-cloud. Sin arquitectura correcta de balanceo, pierdes SLA y dinero. Lo peor: muchas veces no se soluciona con hardware, sino con buenos algoritmos y health checks. Casi gratis, pero a tiempo y con cuidado.
¿Qué cambió para 2026? Nuevas tendencias y realidades
Llegaron los DPU/SmartNIC, descarga eBPF/XDP, Anycast+BGP en perímetro, balanceadores L4 cross-region con millones de paquetes por segundo, y autoescalado basado en métricas reales de sesión. Usamos cada vez más Maglev y ring-consistent hashing, sticky para UDP a nivel 5-tupla o peer-id y session resumption para TLS, IPsec e IKEv2. También vienen algoritmos post-cuánticos — aún en piloto, pero la criptografía ya es más pesada. Todos quieren “escala con minimalismo”: menos trucos complicados, más predictibilidad y automatización.
Patrones arquitectónicos de balanceo para VPN: de L4 a Anycast
Clásico: balanceadores L4 antes del pool de nodos VPN
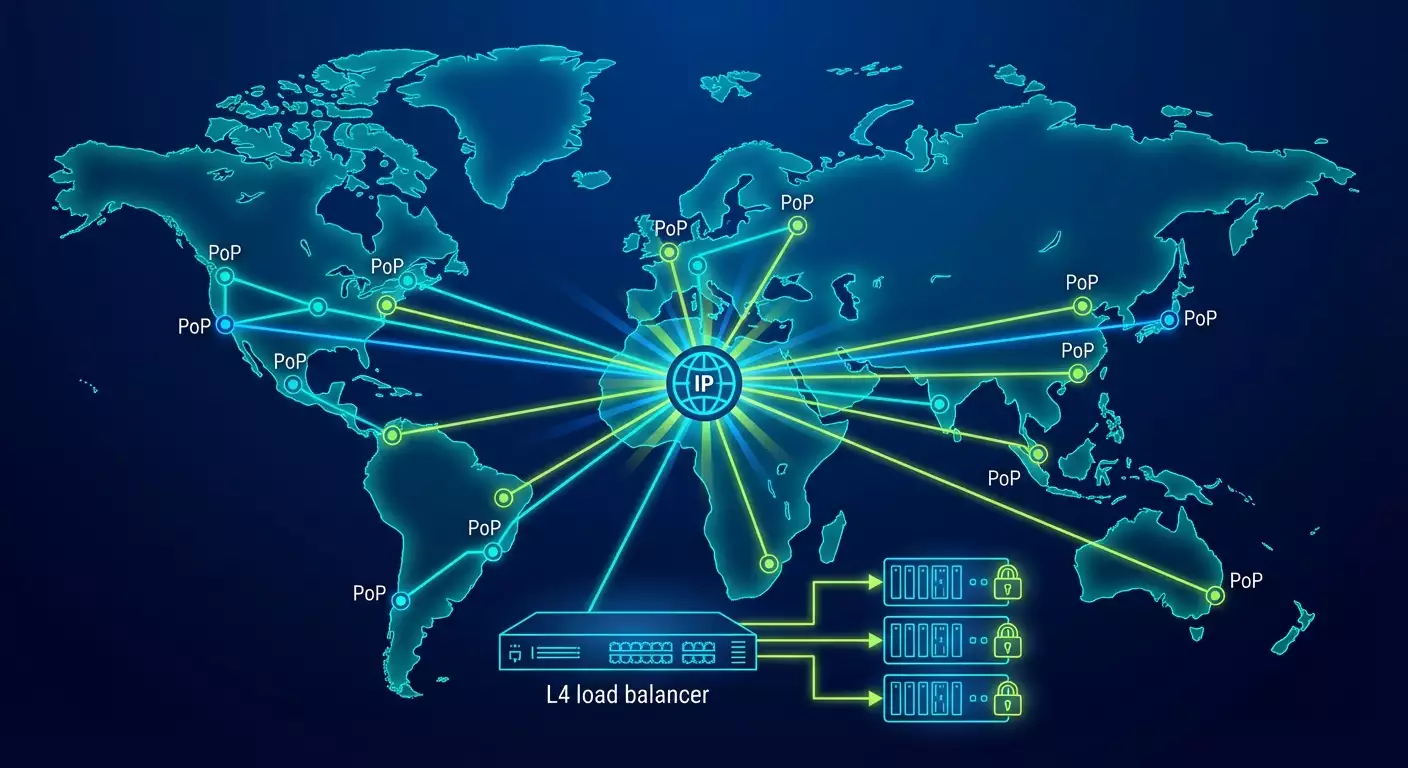
La opción más clara es poner un balanceador L4 delante del pool de servidores VPN que recibe conexiones entrantes y las distribuye. Funciona con OpenVPN (TCP o UDP), WireGuard (UDP), IPsec/IKEv2 (UDP 500/4500). Ventajas: control centralizado, health checks, autoscaling simple. Desventajas: potencial punto único de falla y necesidad de sticky correcta, especialmente para UDP.
¿Qué usan en la práctica? HAProxy, Nginx Stream, Envoy (L4/L7), NLB comerciales y de nube con passthrough directo. La clave es garantizar ruta simétrica y preservar el "flujo" en un mismo nodo. Para TCP es fácil: sesión estable. Para UDP usamos hash de origen/destino para no romper túneles. En flujos grandes — ECMP con ajustes finos.
En ambientes críticos prefieren configuraciones Active-Active con VRRP/keepalived o mecanismos integrados de alta disponibilidad. Y siempre monitoreo Out-of-band, para detectar no solo puertos vivos sino estado real de túneles.
Anycast+BGP en perímetro para PoP globales
Si tienes varias regiones y PoP, Anycast es casi magia. Una misma IP se anuncia desde múltiples ubicaciones vía BGP, y el usuario va al PoP más cercano según rutas del proveedor. Beneficio: mínima latencia y distribución geográfica nativa. Dentro del PoP, distribuyes el tráfico entre nodos balanceadores L4 o DPU. Ya casi tienes la experiencia CDN para el usuario.
Anycast requiere manejo cuidadoso del flapping de rutas, prepends y comunidades para prioridades, y sobre todo failover claro. Si un PoP cae, las rutas deben caer rápido. Tenemos casos con convergencia menor a 30 segundos en fallas y menos de 5 segundos en fail health L4 internos — usuarios casi no notan nada.
Direct Server Return y passthrough sin copias extras
Para máxima capacidad usan DSR y técnicas similares. La idea: el tráfico entrante pasa por el balanceador, pero el saliente va directo del servidor al cliente, saltándose el balanceador. Esto reduce la carga del balanceador pero complica la red. En VPN es menos común por necesidad de estado y cifrado, pero para gateways IPsec en centros de datos funciona con routing simétrico.
Importante: DSR complica el debugging y la diagnosis de túneles debe ser transparente. Si tu equipo no está listo, mejor un L4 “clásico” con buena escalabilidad y métricas claras.
Algoritmos de balanceo: desde simples a avanzados
Round Robin, Weighted RR y por qué no basta
Round Robin es rápido y simple, pero ciego a la realidad: nodos pueden ser desiguales, la carga no uniforme. Weighted RR ayuda si pones pesos según CPU/núcleos/aceleración criptográfica, pero ojo: tráfico VPN es inestable, algunos clientes generan gigabits y miles están casi inactivos. Distribuir por conexiones no es lo mismo que por tráfico. Necesitas foco más “inteligente”.
En casos reales usan Weighted RR como base y luego añaden telemetría y ajuste dinámico de pesos: por ejemplo, si CPU llega a 75%, peso baja un 20%, y si pasa 85%, baja 50%, etc. No perfecto, pero reduce picos.
Least Connections / Least Load y métricas adaptativas
Least Connections va mejor para TCP (OpenVPN-TCP), donde conexiones activas correlacionan con carga. Para túneles UDP (WireGuard, IPsec) medimos peers activos y PPS/BPS. Apareció la métrica «sesiones efectivas»— un número ponderado de clientes según su tráfico en los últimos segundos. El balanceador asigna la nueva conexión al nodo con menor carga efectiva. De ahí el término: Least Load.
En 2026 es norma: al llegar un peer, se elige nodo según métricas CPU, IRQ softnet, PPS, BPS, drop/queue y cantidad de SA activos (IPsec) o peers (WireGuard). Se recopilan con eBPF/Netlink/Prometheus y se actualizan cada 1-3 segundos. Atención a fluctuaciones: filtra ruido con suavizado exponencial.
Consistent Hashing, Maglev y stickiness para UDP
El dolor de UDP: no hay sesiones como en TCP, pero sí estado del túnel. Necesitamos “pegajosidad”: un cliente debe ir siempre al mismo nodo o reestablece túnel, pierde paquetes y se frustra. Usan consistent hashing sobre 5-tupla, IP origen o ID único del cliente. Maglev-hash y ring-consistent hashing mantienen clientes estables al añadir o quitar servidores.
Consejo práctico: si tienes CGNAT en cliente, la IP fuente puede cambiar. Entonces usa claves basadas en certificado cliente (OpenVPN), clave pública peer (WireGuard) o identidad RADIUS/AAA. El balanceador necesita un identificador fijo; si no, stickiness será floja y el túnel migrará con cada reconexión.
Health checks y monitoreo: miramos calidad del túnel, no solo puerto
Verificaciones pasivas y activas
Un simple check TCP/UDP de puerto es básico pero insuficiente. Hacemos chequeos activos: control del handshake en OpenVPN/TLS, IKE_SA para IPsec, ping directo por interfaz túnel o paquete prueba para WireGuard. Un buen health check no solo verifica el daemon, sino que prueba crear un peer test con intercambio cifrado. Sí, más complejo, pero atrapa procesos “vivos pero inútiles” con rutas caídas.
Sumamos telemetría pasiva: tasa de pérdida de paquetes, crecimiento de colas qdisc, errores criptográficos, picos fallos handshake, y latencia cola P95/P99. Si P99 > 200 ms en PoP regional — alerta. Si tasa drop > 0.1% — alerta. Los valores límite los defines según SLO. En 2026 esto ya es estándar.
Checks multicapa y “malla” de decisiones
Un solo health check es débil. Construimos cascada: pings L4 rápidos cada 2 segundos, test funcional extendido cada 10-20 segundos y transacciones sintéticas (ej. conexión simulada) cada minuto. La exclusión de nodo se decide por mayoría de señales, para que un sensor falso no caiga el servicio. El nodo vuelve vía cascada con histéresis.
Además, probes externas desde vantage points independientes: agentes externos de distintos ASN chequean Anycast y miden latencia real. Esto evita casos donde “dentro todo verde” pero usuarios sufren por fallos proveedor o MTU. Vimos un caso con alternancia de rutas ECMP que cortaba parte del tráfico mientras todo en PoP brillaba en verde. Solo la prueba externa expuso el problema.
Falsos positivos y debounce
Errores ocurren. UDP se pierde, CPU pica momentáneamente, GC atrasa procesos. Usa debounce: N fallos consecutivos, ventanas de observación, intervalos exponenciales. Y registra no solo el fallo, sino el contexto: métricas fuera de rango, carga, cambios en configuración. El diagnóstico postincidente es tu upgrade gratis.
Persistencia de sesión para VPN: cómo “pegar” al cliente bien
Sticky por 5-tupla, IP fuente e ID de usuario
Solución básica: pegado por 5-tupla: IP src, puerto src, IP dst, puerto dst, protocolo. Para TCP funciona. En UDP, donde puerto origen varía, mejor un identificador más estable. En OpenVPN vale CN del certificado o usuario RADIUS, en WireGuard la clave pública del peer, en IKEv2 IDi/IDr o identificador EAP. Ideal que balanceador lea estos datos en handshake o trabaje con controlador que pase el mapeo.
Clave más estable, menos migraciones y mejor experiencia usuario: nadie quiere que el túnel “salte”, aunque reconecte en segundos. Medimos que pasar peer a otro nodo tras actualización sube latencia P99 un 30-60% por 1-2 minutos. Se soluciona con sticky y drain-mode buenos.
Drain-mode, recarga suave y actualizaciones rolling
No golpees usuarios en cada update. Antes de desplegar un build o cambio, pon nodo en drain: no toma nuevos clientes y sigue los actuales. En 5-15 minutos (según timeouts y actividad) la mayoría de sesiones migran naturalmente a otros nodos. Luego haz restart suave — ruptura mínima o idealmente rotación sin corte de workers. Solo entonces reincorpora nodo al pool.
WireGuard es simple pero ojo: recrear interfaz puede resetear peers. Actualiza con atomic apply, reglas precargadas y luego switcheo. OpenVPN? Mantén sesiones con TLS session resumption y evita key rotation en pico.
Compartir estado y directorio de sesiones
¿Dónde guardar estado para migración? Algunas arquitecturas usan session directory — caché central mapa cliente → nodo accesible para balanceador y capa control-distribución. No replica todo el estado criptográfico, pero direcciona bien el próximo handshake. En IPsec, similar: sincronización de SA entre nodos activos. En 2026 hay productos y open-source que replican parcialmente SA o las recuperan rápido en failover. No siempre se necesita réplica completa; un “handshake rápido” con redirección correcta suele bastar.
Escalar VPN: vertical, horizontal y autoescalado inteligente
Escalado vertical: cuándo conviene
CPU potentes, AES-NI, ChaCha20-Poly1305, aceleración DPU — todo acelera VPN. Subir verticalmente tapa rápido déficit pero tiene techo: el costo sube, la escalabilidad disminuye y un fallo pega fuerte. En instalaciones pequeñas (hasta 2-3 Gbit/s) es rentable. Más allá, conviene paralelizar.
¿Cómo saber límite? Si un nodo aguanta 10-12 Gbit/s WireGuard con 70-80% CPU y métricas IRQ al límite, es hora de escalar horizontal. Activa tuning NUMA-friendly, pinning de interrupciones, RSS, aumenta net.core.rmem/wmem, iguala MTU y expande horizonalmente.
Escalado horizontal, clusters y Anycast
Escalar en horizontal es aliado. Añades nodos, balanceador reparte peers, Anycast lleva usuarios al PoP más cercano. Clave del éxito: mínimo “costo” agregar nodo: bootstrap automático, configs vía GitOps, chequeo readiness, inclusión en pool. Y drain simple para salida.
En multi-cloud vemos combos: NLB cloud regional, pool VM con WireGuard/OpenVPN, config-manager y monitoreo externo, y al frente IP Anycast anunciado en regiones. Funciona mientras health checks son confiables y sticky por ID usuario se mantiene.
Autoescalado con señales correctas
Autoescalar por CPU es burdo. En 2026 mejor fijarse en “sesiones efectivas”, PPS/BPS, latencia P95/99, aumento de fallos handshake y drop-rate. Reglas claras: si P95 sube 30% en 3 minutos y PPS excede X por nodo — levanta uno nuevo. Si carga cae estable 15 minutos — pon uno en drain. Para evitar inestabilidad, fija min/máx y cooling entre acciones.
Ojo con el costo: cada nodo extra es gasto. Por eso activa economía: si carga es estacional (ej. 9-11am), mantener una reserva “caliente” 10-15% arriba del promedio es sensato. Pagarás con estabilidad y menos nervios ante caídas de picos.
Seguridad y resiliencia: DDoS, Zero Trust y cumplimiento
Protección contra UDP-flood y particularidades L7
VPN suele ir por UDP, blanco favorito de DDoS. En perímetro usa filtrado por tasa, prefiltrado en proveedor, limitación eBPF para paquetes handshake, ajuste conntrack. Activa protección anti-flood en balanceador y preferiblemente whitelist por AS o geolocalización (si negocio lo permite). No olvides cookies o “puzzle” en handshake en soluciones comerciales — baja costo de ataque para ti y aumenta el costo para atacante.
En capa L7 para OpenVPN/TLS e IPsec/IKEv2 usa suites criptográficas estrictas, desactiva algoritmos obsoletos, aplica Perfect Forward Secrecy, renueva certificados a tiempo y usa HSM/DPU donde tenga sentido. Nada de “activar MD5 temporalmente”. Nunca.
Zero Trust y segmentación
VPN sin segmentación es como tener llave maestra para todas las puertas en un mismo llavero. En 2026 eso no va. Aplica routing basado en políticas, posture check, tokens de corta duración y ligadura a identidad (IdP, MFA). Segmenta por rutas, ACL y hasta geografía de PoP. El balanceador debe entender dónde aplicar políticas y qué nodos sirven a cada grupo de usuarios. Seguridad, rendimiento y control de costos en uno.
Cumplimiento y registros
Los logs VPN son artefactos legales valiosos en muchas industrias. Guarda metadatos de conexión, razones de fallos, versiones clientes, parámetros criptográficos. Anonimiza donde sea necesario y cumple reglas locales de almacenamiento. Si Anycast dirige usuarios a otra región, asegúrate de que política lo permita. El balanceo no debe romper cumplimiento.
Escenarios prácticos y plantillas para OpenVPN, WireGuard e IPsec
WireGuard: UDP rápido y exigente con sticky
WireGuard prefiere minimalismo y rapidez. Para balanceo usa L4 con consistent hash por clave pública del peer. Entrada—IP Anycast en PoP, dentro—NLB/HAProxy/Envoy con ring-hash. Health checks: peer test, keepalive, monitoreo handshake. Para autoscaling: métricas PPS/BPS y peers activos. Updates vía drain y apply atómico de configs. Así manejamos 60 mil peers activos simultáneamente con P99 bajo 120 ms en tres regiones.
Tuning: net.core.rmem_max, rmem_default, busy_poll en interfaces, offloads NIC correctos, pinning IRQ a núcleos. Cripto ChaCha20-Poly1305 acelera escenarios CPU-bound. Seguridad: limita nuevos peers bajo ataques, activa rate-limit en handshakes.
OpenVPN: TCP/UDP y flexibilidad
OpenVPN sigue siendo "todoterreno". Para TCP balancear es más simple: Least Connections más session resumption, sticky por sesión TLS. En UDP haz sticky por CN certificado o username, si no reconexiones saltan. Health checks: handshake TLS prueba, ping túnel, logs renegociación. En grandes instalaciones separa control y data plane, shardea por grupos usuarios.
Caso: fintech con millón de MAU y pico hasta 85k sesiones simultáneas. Pasaron de RR estático a Least Load adaptativo por CPU+PPS+latencia P95, sumaron drain-mode en releases, bajaron reconexiones un 42% y P99 latencia en tardes un 35%. Todo sin nuevo hardware.
IPsec/IKEv2: robusto y algo “más pesado”
IPsec es bueno para site-to-site y mobilidad empresarial. Balanceo via Anycast en perímetro, luego L4 con consistent hashing por ID IKE (IDi) o login EAP. Crucial mantener sincronía SA al hacer failover. Sin réplica completa, asegúrate de rekey rápido con redirección correcta. Health checks incluyen SA de prueba y control drop ESP. No olvides NAT-T en UDP 4500 y MTU grande/frags. Performance gana mucho con offloads en SmartNIC/DPU.
Métricas, SLO y economía: cómo saber que todo funciona
Conjunto de métricas por nodo y cluster
No sólo CPU y memoria. Crítico: PPS/BPS entrada y salida, sesiones activas/peers, tasa handshake, drop/queue en interfaces, latencia P50/P95/P99, tasa error criptografía, retransmisiones TCP, fragmentación UDP. Internas del balanceador: distribución por algoritmo, % saltos sticky, tiempo respuesta en health-fail. Estas permiten detectar anomalías a tiempo.
En cluster mide uniformidad: coeficiente de variación carga entre nodos. Si CV > 0.25 persistente, algoritmo falla o hay “clientes pesados”. Pon cuotas a clientes o grupos: limita PPS pico para evitar que uno rompa a todos.
SLO y alertas sin histeria
Formula SLO: disponibilidad Anycast PoP 99.95% mensual, latencia P99 < 150 ms regional, tasa reconexión < 1.5% por hora en 10k sesiones, error handshake < 0.4%. Alertas si se supera tiempo N minutos, con supresión de “tormenta” en picos. Reportes con recomendaciones, no sólo luz roja: añadir nodo, activar drain, chequear rutas ASN-X, subir MTU.
Costo y planificación de capacidad
El dinero manda. Planifica capacidad según ventanas temporales “pesadas” reales. Analiza histórico: qué % carga genera el top 1% clientes? Si mucho, entra rate-limit. En PoP mantén 20% capacidad reserva, global 10%. Autoescalado en nube debe atarse a presupuesto para evitar “explosiones” nocturnas por bugs en métricas.
Errores y antipatrón más comunes
Se balancea por conexiones, no por carga real
Error clásico: contar sesiones y celebrar. Al final, un nodo carga varios “elefantes” y otros muchas “ratitas”, con sesiones igualadas pero carga desigual. La solución es medir PPS/BPS y usar Least Load con pesos reales. Más cuotas para “elefantes”.
Health check solo “puerto vivo” y ya
El puerto puede estar vivo, pero el túnel no. Añade chequeos funcionales, transacciones sintéticas y probes externas. Aplica histéresis y cascada de decisiones para evitar saltos por fallas temporales.
Sin drain-mode ni actualizaciones suaves
Con un rollback masivo, usuarios explotan y SLA cae. No seas héroe. Pulsa drain, espera que sesiones migren, aplica update y vuelve al pool. Tranquilo y sin sobresaltos.
Plan paso a paso para implantar balanceo en VPN
Paso 1. Mide, no supongas
Recolecta métricas: PPS/BPS, peers, tasa handshake, latencia, drop. Construye perfiles temporales y detecta picos. Sin datos todo es adivinanza.
Paso 2. Escoge arquitectura
Escala pequeña y media: balanceador L4 antes del pool, sticky por ID usuario, health checks con peer test. Escala global: Anycast+BGP en perímetro, dentro NLB/HAProxy/Envoy, autoscaling y probes externas desde distintos ASN.
Paso 3. Configura algoritmos y sticky
Empieza con Least Load y hash consistente por ID estable (CN, clave pública, IDi). Verifica fluctuaciones al añadir/quitar nodo. Activa cuotas para “elefantes” y migración suave con drain.
Paso 4. Health checks y cascada de decisiones
Implementa checkers L4 rápidos, tests funcionales lentos y probes sintéticos externos. Define umbrales, ventanas y política de retorno. Documenta todo — agradecerás en el primer incidente.
Paso 5. Autoescalado y economía
Asocia autoescalado a métricas calidad (P95, drop) y carga (PPS/BPS). Fija mínimos/máximos, presupuesto y enfriamiento entre acciones. Prueba en entorno controlado “tormenta” de conexiones y ataque UDP.
Paso 6. Seguridad y cumplimiento
Verifica política criptográfica, logs y segmentación. Activa rate-limit en handshakes, filtros perímetro, revisa MTU. Considera SmartNIC/DPU si precio lo justifica.
Casos prácticos: qué funcionó y qué no
Caso 1: Fintech y picos vespertinos
Cliente con pico en la tarde: reportes analíticos móviles por VPN con hasta 85k sesiones simultáneas. Cambiaron de Weighted RR a Least Load, sticky por CN, añadieron drain-mode y triple health check. Resultado: 35% menos latencia p99 en pico, 42% menos reconexiones y ahorro de 2 nodos por distribución uniforme.
Caso 2: Anycast y multi-cloud
SaaS global con PoP en 6 regiones. Anycast llevó usuarios al PoP más cercano, dentro NLB con ring-hash por clave pública WireGuard. Monitoreo externo permitió aislar región degradada en 20-30 s gracias a BGP y health checks ágiles. Alcanzaron 99.97% uptime en trimestre.
Caso 3: DDoS y saturación de handshakes
Flood UDP a puertos WireGuard generó avalancha de handshakes. Activaron rate limit eBPF, cookie check en handshake y filtrado en proveedor. Bajaron frecuencia repetida de handshakes temporalmente. P95 volvió a normal en 7 minutos, negocio solo detectó leve "lag" en 5 minutos.
Checklist antes de producción: ¿no olvidamos nada?
Técnico
- Algoritmo distribución: Least Load + hash consistente
- Sticky por ID estable de cliente
- Cascada health checks: rápido, funcional, externo
- Drain-mode y actualizaciones gracefull
- Autoescalado en P95/PPS/BPS y límites presupuestarios
- Logs, alertas, SLO y post-mortems
Red
- Anycast+BGP para PoP global
- MTU y fragmentación correctas
- Simetría ECMP y diagnóstico rutas
- Filtros en perímetro, rate-limit en handshake
Organizativo
- Documentación y runbook
- Test de incidentes y simulacro “tormenta”
- Ajuste cumplimiento regional
- Plan rollback en 5 minutos
FAQ: preguntas frecuentes sobre balanceo VPN
¿Qué algoritmo elegir primero?
Empieza con Least Load y consistent hashing por ID estable de cliente. Da balance razonable y sesiones estables sin rebotes al añadir nodos. Round Robin déjalo para pruebas.
¿Necesito Anycast si solo tengo un país?
Si tienes varias regiones dentro del país y usuarios geográficamente distribuidos, Anycast ayuda a reducir latencia y tener redundancia PoP. Pero para una sola ciudad y PoP el beneficio es mínimo — enfócate en buen L4 y health checks.
¿Cómo hacer sticky para WireGuard?
Usa consistent hash por clave pública peer. Es más estable que IP origen, especialmente con CGNAT. Guarda mapeo peer → nodo en balanceador o controlador para que handshake nuevo no cambie de servidor.
¿Qué verificar en health checks además del puerto?
Handshake, intercambio de paquetes test por túnel, latencias P95/P99, tasa de drop, errores criptográficos y aumento de colas. Probes externos desde varios ASN son imprescindibles para detectar fallas de proveedor.
¿Cómo actualizar sin downtime?
Activa drain-mode, espera migración natural de sesiones, haz reinicios suaves o sin pérdida. Para WireGuard aplica configs atómicos, para OpenVPN session resumption, para IPsec rekey rápido con redirección correcta.
¿Vale la pena invertir en DPU/SmartNIC?
Si tienes decenas de gigabits por nodo y necesitas baja latencia bajo carga, sí, se paga. Para instalaciones pequeñas mejor mejora el balanceo L4, autoescalado y stack de red.
¿Qué SLO poner al inicio?
Disponibilidad 99.9-99.95% PoP, latencia P99 < 150 ms usuarios regionales, tasa reconexión < 2% hora en 10k sesiones, error handshake < 0.5%. Luego endurece según madurez.
