Hub-and-Spoke vs Full Mesh: Planung von Unternehmens-VPNs für 5, 20 und 100 Niederlassungen
Der umfassende Leitfaden zur Auswahl und Gestaltung von Unternehmens-VPN-Topologien Hub-and-Spoke und Full Mesh für 5, 20 und 100 Niederlassungen. Praxis, Checklisten, Protokolle, Ausfallsicherheit, Sicherheit, Wirtschaftlichkeit, Monitoring und echte Enterprise-Fallstudien.
Inhalt des Artikels
- Einleitung: warum ein vergleich von hub-and-spoke und full mesh im jahr 2026 wichtig ist
- Grundlagen: kernkonzepte und terminologie
- Tiefergehende analyse: von architekturmustern zu risikomanagement
- Praxis 1: topologieauswahl nach skalierung – 5, 20 und 100 niederlassungen
- Praxis 2: schritt-für-schritt-planung von hub-and-spoke
- Praxis 3: planung von full mesh und partial mesh
- Praxis 4: wirtschaftlichkeit, kapazitätsplanung und betrieb
- Praxis 5: sicherheit, compliance und zero trust
- Praxis 6: cloud-hubs, sase und hybride modelle
- Praxis 7: piloten, pocs und schneller start
- Typische fehler: was sie vermeiden sollten
- Tools und ressourcen: was sie nutzen sollten
- Fallstudien und ergebnisse: beispiele aus der praxis
- Faq: komplexe fragen und ausführliche antworten
- Fazit: strategischer rahmen und nächste schritte
Einleitung: Warum ein Vergleich von Hub-and-Spoke und Full Mesh im Jahr 2026 wichtig ist
Digitale Prozesse wachsen, verteilte Teams und Niederlassungen sind inzwischen die Norm. Gleichzeitig steigen die Anforderungen an den Schutz der Verbindungen, Transparenz und Wiederherstellungszeiten. Einen Standort an die Zentrale anzubinden ist einfach geworden; eine vorhersehbare Performance, Steuerbarkeit und Skalierbarkeit auf dutzenden Standorten sicherzustellen, ist deutlich anspruchsvoller. In diesem Artikel beleuchten wir systematisch, wann eine Hub-and-Spoke-Topologie für Unternehmensnetzwerke sinnvoll ist und wann Full Mesh oder hybride Partial Mesh-Modelle die bessere Wahl darstellen. Wir führen Sie vom Basiswissen über tiefgreifende Architekturprinzipien bis hin zu praktischen Methoden für Netzwerke mit 5, 20 und 100 Niederlassungen. Freuen Sie sich auf Schritt-für-Schritt-Anleitungen, Checklisten, Standardkonfigurationen, Kennzahlen zur Kontrolle und praxisnahe Enterprise-Fallstudien. Unser Ziel: Ihnen eine verlässliche Entscheidungsgrundlage zu bieten, um Risiken, Investitionen und Einführungszeiten zu minimieren.
Grundlagen: Kernkonzepte und Terminologie
Topologien
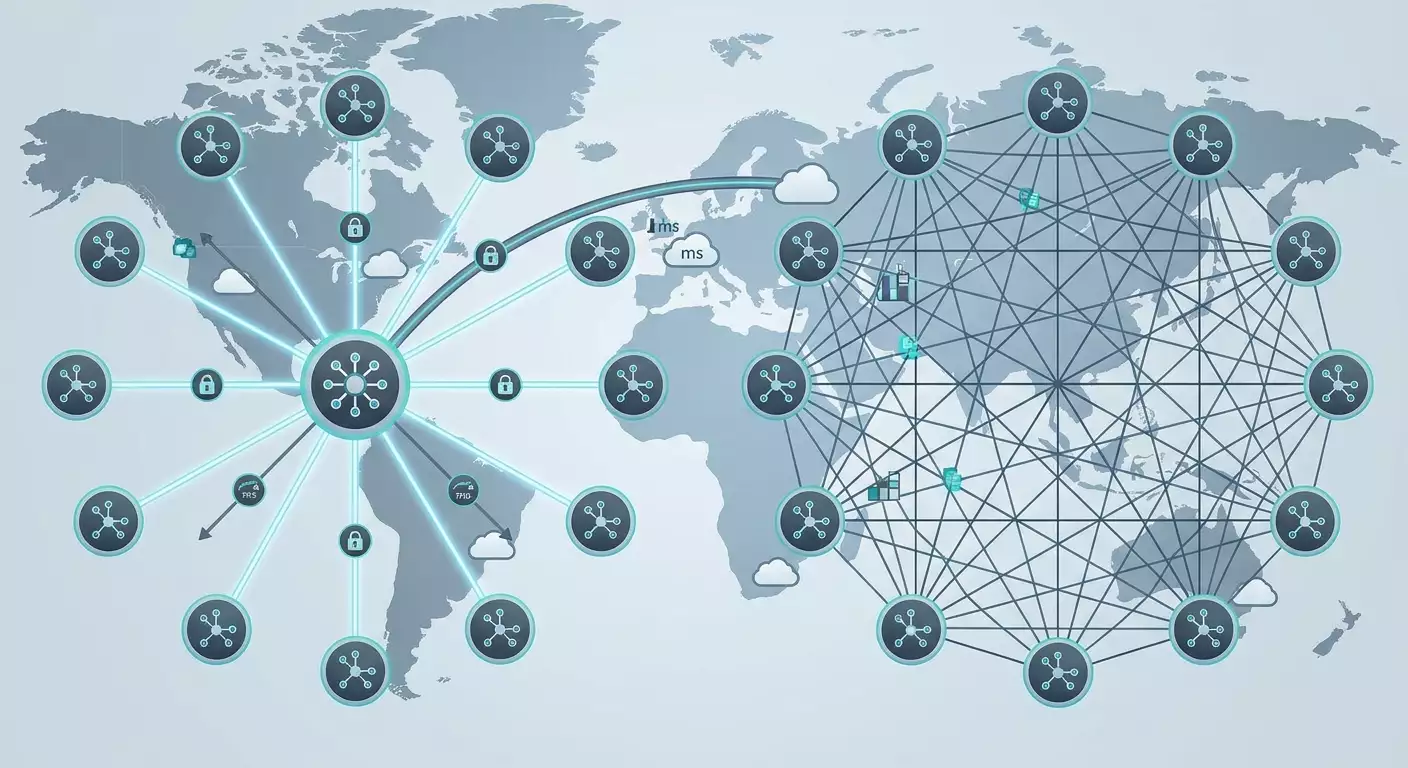
- Hub-and-Spoke: Zentrale als Hub, Niederlassungen als Spokes. Die gesamte zwischenbetrieblichen Kommunikation läuft über den Hub. Vorteile: Einfachheit, zentrale Kontrolle, transparentes Traffic-Engineering. Nachteile: mögliche Single Point of Failure und Engpässe bei Bandbreite und Latenzen.
- Full Mesh: Jeder Standort ist direkt mit jedem anderen verbunden. Pluspunkt: minimale Verzögerungen zwischen Niederlassungen, hohe Ausfallsicherheit. Nachteil: quadratisch wachsendes Tunnel- und Policy-Volumen, komplexe Verwaltung.
- Partial Mesh: Hybridmodell, bei dem kritische Knoten direkt verbunden sind, andere über Hubs oder regionale Aggregatoren laufen.
Transport und Overlay
- Underlay: Internet, MPLS L3VPN, Mobilfunkverbindungen, LTE/5G, DIA, Breitband. Von hier hängen Latenz, Jitter und Paketverluste ab.
- Overlay: Geschützte Tunnel – IPsec, WireGuard, OpenVPN, IKEv2, SSTP, L2TP. Hier erfolgen Verschlüsselung, Authentifizierung und Routing.
Routing
- Statisch: Einfach, aber schlecht skalierbar.
- OSPF: IGP für dynamisches Routing innerhalb einer Autonomen Systemgrenze, praktisch bei größeren Hub-and-Spoke-Netzen.
- BGP: Für Multi-Domain-Szenarien, Skalierung in sehr großen Netzen und Multi-Hub-Architekturen, ideal für SD-WAN und Internet-Routing von Overlay-Präfixen.
Sicherheit
- Kryptoprofile: Sets aus Algorithmen und Parametern – IKEv2, AES-GCM, ChaCha20-Poly1305, PFS, Schlüssellänge, Rotation der Security Associations.
- Authentifizierung: X.509, EAP-TLS, PSK, Integration in das unternehmenseigene PKI.
- Segmentierung: VRF, VLAN, policy-basiertes Routing, Sicherheitsgruppen für die Trennung kritischer Segmente.
Observability (Nachvollziehbarkeit)
- Telemetrie: SNMP, NetFlow/IPFIX, sFlow, gNMI, Export von Tunnelmetriken und Logs.
- SLO/SLA: Latenz, Paketverluste, Jitter, Verfügbarkeit sowie Konfigurations- und Wiederherstellungszeiten.
Tiefergehende Analyse: Von Architekturmustern zu Risikomanagement
Wann Hub-and-Spoke sinnvoll ist
Wenn die meisten Anwendungen in Rechenzentren oder Cloud-Hubs laufen und die zwischenbetrieblichen Datenflüsse gering sind, sorgt Hub-and-Spoke für vorhersehbares Routing, simple Segmentierung und Kontrolle der Internetzugangspunkte. Es erleichtert DLP und Traffic Inspection. Risiken sind Lastkonzentration und Abhängigkeit vom Hub, was sich durch Skalierung des Hubs, Active-Active-Cluster, regionale Aufteilung und korrektes QoS managen lässt.
Wann Full Mesh lohnt
Dominiert East-West-Traffic zwischen Niederlassungen, z. B. Sprachdienste oder direkte Replikation, reduziert Full Mesh Verzögerungen und eliminiert den Umweg über den Hub (Hairpinning). Risiken sind Komplexität und Skalierung, die sich durch Automatisierung, SD-WAN-Controller, BGP mit Route Reflector-Logik und Einführung von Partial Mesh für kritische Verbindungen reduzieren lassen.
Partial Mesh als Kompromiss
Oft genügt es, direkte Tunnel nur zwischen den Gruppen mit den höchsten Verkehrsvolumina zu errichten und die übrigen Verbindungen über Hubs zu führen. So erreichen Sie etwa 80 % der Vorteile von Full Mesh mit nur 20 % des Aufwands.
Trends 2026
- Wachsender Einsatz von WireGuard in Niederlassungsszenarien dank Einfachheit und Performance auf General-Purpose-CPUs.
- SD-WAN als Standardlösung für Overlay-Automatisierung, dynamische Underlay-Auswahl, application-aware Routing und zentrale Policy-Verwaltung.
- Verschmelzung von VPN und Zero Trust: Geräteauthentifizierung, Zustandsprüfung (Posture Check), Mikrosegmentierung.
- Weit verbreiteter Einsatz von Cloud-Hubs und POPs mit regionalen Aggregatoren nahe beim Anwender.
- Infrastructure as Code für Netzwerke: deklarative Beschreibungen von Topologien und Policies.
Praxis 1: Topologieauswahl nach Skalierung – 5, 20 und 100 Niederlassungen
Entscheidungsmethodik
- Analysieren Sie dominante Verkehrsflüsse: Niederlassung-RZ, Niederlassung-Cloud, Niederlassung-Niederlassung.
- Messen Sie Netzwerk-SLOs: RTT p95, Jitter p95, Paketverluste, Verfügbarkeit.
- Abgleich der Anwendungsanforderungen: Sprache und Video sind latenzsensitiv, ERP reagiert empfindlich auf Verluste, Storage auf Jitter.
- Klären Sie regulatorische Vorgaben: z. B. DSGVO, PCI DSS, ISO 27001, branchenspezifische Standards.
- Erstellen Sie eine Nutzen-/Risikomatrix für Topologien und wählen Sie die minimal notwendige Komplexität.
Szenario: 5 Niederlassungen
- Empfehlung: Hub-and-Spoke mit einem ausfallsicheren Mini-Hub oder einem Active-Active-Duo in verschiedenen Regionen.
- Routing: OSPF oder statisch mit zentraler Weiterleitung über den Hub.
- Krypto: WireGuard oder IKEv2/IPsec mit PFS, AES-GCM oder ChaCha20-Poly1305.
- QoS: 3-4 Klassen – Sprache, kritische Anwendungen, Bulk, Best-Effort.
- SLA: Hub-Verfügbarkeit 99,95%+, Latenz Niederlassung-Hub maximal 40-60 ms für Sprachverkehr.
Szenario: 20 Niederlassungen
- Empfehlung: Hub-and-Spoke mit 2 regionalen Hubs und Partial Mesh zwischen 4-6 der meistbelasteten Niederlassungen.
- Routing: OSPF innerhalb der Regionen, BGP zwischen Regionen und Cloud-Hubs.
- Segmentierung: VRF je Business Unit, Abgrenzung der Internetzugänge an lokalen Breakout-Punkten.
- Observability: NetFlow-Export, synthetische Tests, Dashboards p95, p99.
- Automatisierung: Ansible oder SD-WAN Controller für das Pushen von Tunneln und Policies.
Szenario: 100 Niederlassungen
- Empfehlung: Hierarchische Architektur mit regionalen Hubs, Partial Mesh für Hot Traffic Gruppen und zentralisierten Cloud POPs für SaaS.
- Routing: BGP an den Regionengrenzen, OSPF intern, Route Reflector-Logik für Skalierung.
- Resilienz: Active-Active-Hubs, ECMP, SLA-basierte Auswahl des Underlays, automatisches Failover auf Basis von Messungen.
- Segmentierung: VRF je Sicherheitsdomäne, Mikrosegmentierung auf Policy-Ebene.
- Compliance: Audit-Trails, Kryptoprofile, Zugangsprotokolle, Geo-Traffic-Kontrolle.
Praxis 2: Schritt-für-Schritt-Planung von Hub-and-Spoke
Schritt 1. Adressraum und Segmentierung
- Weisen Sie jeder Niederlassung eindeutige Präfixe zu. Vermeiden Sie Überschneidungen: Häufig genutzte 10.0.0.0/8-Netze sollten vorsichtig segmentiert werden.
- Definieren Sie VRFs: Produktionsverkehr, Office, Gast-WLAN, OT.
- Planen Sie Firewall-Zonen am Hub sowie intra- und inter-VRF-Policies.
Schritt 2. Auswahl der Tunnelprotokolle
- WireGuard: Einfachheit, hohe Performance, gut automatisierbar. Ideal für Niederlassungen ohne Hardware-Krypto-Beschleuniger.
- IPsec IKEv2: De-facto-Enterprise-Standard, Hardware-Offload, flexible Kryptoprofile, breite Vendor-Kompatibilität.
- OpenVPN: Vielseitig, aber weniger performant. Einsatz vor allem zur Kompatibilität.
Schritt 3. Kryptoparameter
- PFS aktiviert, Gruppen mit äquivalent zu 3072 Bit oder höher, Lebensdauer der SA 1–4 Stunden mit Rotation variabel.
- Verschlüsselungen: AES-256-GCM oder ChaCha20-Poly1305. Kontrolle zulässiger Algorithmen.
- Authentifizierung: EAP-TLS oder Zertifikate aus Unternehmens-PKI, CRL/OCSP.
Schritt 4. Routing
- OSPF in Niederlassungsbereichen: area pro Region, stub oder NSSA zur Reduktion von LSA-Fluten.
- Default-Routen-Verteilung vom Hub zu Niederlassungen, Rückrouten über Summarization.
- Traffic Policies am Hub: PBR für Sprachdienste, lokales Breakout für SaaS mit Traffic Inspection.
Schritt 5. Ausfallsicherheit
- Zwei Hubs im Active-Active-Modus in unterschiedlichen Availability Zones, synchronisierte Policies.
- Schnelles Failover: BFD für dynamisches Routing, IKE DPD, SLA-Probes.
- Backups für Underlay: DIA + LTE/5G. SD-WAN ermöglicht Per-Flow-Steuerung basierend auf Verlusten und Jitter.
Schritt 6. QoS und MTU
- Klassen: EF für Sprache, AF für wichtige Anwendungen, BE für übrigen Traffic. DSCP-Markierung an der Quelle, Mapping auf WAN.
- Berücksichtigung des Overheads: IPsec erhöht um 50-70 Bytes, WireGuard circa 60 Bytes. Setzen Sie MSS-Clamping und MTU-Discovery ein und testen Sie die Pfade gründlich.
Schritt 7. Monitoring und Betrieb
- Dashboards: Tunnel-Verfügbarkeit, p95 RTT, p95 Jitter, Verluste, Volumen pro QoS-Klasse.
- Alarming: SLA-Schwellenwerte, Alerts bei Verschlechterung, automatische Underlay-Umschaltung.
- Change Management Prozesse: Canary-Rollout, Rollbacks, Postmortems bei Vorfällen.
Praxis 3: Planung von Full Mesh und Partial Mesh
Full Mesh ohne Schmerzen
- Nutzen Sie zentralen Controller oder IaC. Beschreiben Sie Meshes deklarativ, generieren Sie Schlüssel und Peers automatisiert.
- Bei IPsec setzen Sie BGP über die Tunnel ein. Verwenden Sie Communities zur Steuerung der Ankündigungen, um Überpropagation zu vermeiden.
- Präfixsummarization am Standort: Minimieren Sie Tabellengrößen. Kleine Netze aggregieren /24 oder /23 je nach Design.
Partial Mesh als gezielte Beschleunigung
- Identifizieren Sie Top-10-Paare von Niederlassungen nach Volumen oder Latenz. Bauen Sie direkte Tunnel nur für diese.
- Überprüfen Sie regelmäßig das Mesh-Set auf tatsächlichen Traffic. Entfernen Sie ungenutzte Verbindungen, fügen Sie neue hinzu.
- Achten Sie auf symmetrisches Routing: BGP Local-Pref und MED für korrekte Pfadwahl.
Segmentierung und Sicherheit
- VRF pro Segment + Route-Target für Import nur benötigter Präfixe. Im Full Mesh vermeiden Sie Full Import, setzen Sie selective Import ein.
- Kontrolle von East-West-Traffic: Layer 4-7 Policies zwischen Segmenten, Logging und Drift-Checks von Policies.
Performance
- Krypto-Tuning: Hardwarebeschleuniger wie AES-NI, Multi-Threading. Für WireGuard CPU-Pinning auf x86-Routern in Niederlassungen.
- Optimierung von Keepalive: Anpassung an mobile und NAT-Umgebungen, Minimierung unnötigen Chats.
Praxis 4: Wirtschaftlichkeit, Kapazitätsplanung und Betrieb
TCO-Modell
- Capex: Ausstattung der Hubs, Lizenzen, Implementierung.
- Opex: Leitungen, Support, Monitoring, SOC, Abschreibungen.
- Versteckte Kosten: Zwischenfälle, Ausfälle, menschliche Fehler, Team-Umschichtungen.
Kapazitätsplanung
- Berechnung von Spitzenverkehr je Klasse. Planen Sie Puffer von 30-50 % an den Hubs, 20-30 % für Niederlassungen.
- Worst-Case-Szenarien modellieren: Ausfall des Underlays, Verschlechterung, Lastspitzen bei Updates.
- Tests: synthetische Last, iperf mit realem MTU- und QoS-Set.
Qualitätsmanagement
- Policies zur Jitter-Stabilisierung: Pufferung in Sprach-Gateways, Priorisierung von EF.
- Traffic Shaping am Ausgang, Policing am Eingang. Vermeiden Sie Bufferbloat.
Betriebliche Praktiken
- IaC: Speichern Sie VPN-Manifestdateien im Git, CI zur Syntax- und Policy-Prüfung, CD für Deployments.
- Runbooks: Abläufe für Standort-Start, Failover, Schlüsselrotation, Hardwarewechsel.
- Regelmäßige Game Days: Tests von Ausfall-Szenarien und RTO-Zeiten.
Praxis 5: Sicherheit, Compliance und Zero Trust
Kryptografische Hygiene
- Minimal erforderliche Algorithmen, Verbot veralteter Sets.
- Regelmäßige Rotation von Schlüsseln und Zertifikaten, automatisierte Erinnerungen und Ersetzungen.
- PFS stets aktiviert, Trennung von Control Plane und Data Plane Policies.
Zugriffskontrolle
- Zugriff nach dem Prinzip der minimalen Rechte, Bindung an Geräte und Nutzer.
- Segmentierung: Kritische Dienste in eigenem VRF, Inter-VRF-Firewallfiltern.
Compliance
- Protokollierung: Wer, wann, auf welche Ressourcen zugriff. Speicherung nach Standardanforderungen.
- Asset-Management: Inventar von Tunneln, Zertifikaten, Schlüsseln, Geräten.
- Daten-Lokation: Geobeschränkungen der Routen, Vermeidung von Transit durch unerwünschte Regionen.
Zero Trust Integration
- Gerätezustandsprüfung vor Zugangserteilung.
- Mikrosegmentierung auf Anwendungsebene, Proxy-bewusster SaaS-Zugang.
Praxis 6: Cloud-Hubs, SASE und hybride Modelle
Cloud-Hubs
- Platzierung der Hubs nah an den Nutzern – Reduktion der RTT für SaaS.
- Multi-Cloud-Unterstützung: Verkehr zu Cloud-Ressourcen wird innerhalb der Cloud-Fabrik abgefangen, ohne Umweg über On-Premises.
SASE und SD-WAN
- Schutz an der Peripherie: CASB, SWG, DLP in der Cloud, Integration mit VPN.
- Application-aware Routing: Kritischer SaaS-Traffic nimmt den kürzesten Pfad mit garantierter QoS.
Hybride Topologien
- Hub-and-Spoke für On-Prem, Partial Mesh für sensible Anwendungen, Cloud-POP als SaaS-Beschleuniger.
Praxis 7: Piloten, PoCs und schneller Start
Pilot in einer Woche
- Definieren Sie Zielmetriken: p95 RTT, Paketverluste, Verfügbarkeit, Failover-Zeit.
- Wählen Sie 2-3 Niederlassungen mit verschiedenen Underlays aus.
- Richten Sie zwei Topologien ein: reines Hub-and-Spoke und Partial Mesh zwischen zwei Standorten.
- Sammeln und vergleichen Sie Metriken sowie SLA und UX der Anwendungen.
Schneller Start ohne langwierige Beschaffungszyklen
Für Piloten und kurze PoCs ist ein persönlicher VPN-Server als Managed Service ideal. Dabei ist der Service von vpn.how sehr praktisch: Dedizierter Server ohne Sharing mit eigener IP, unterstützt WireGuard, OpenVPN, IKEv2, L2TP, SSTP je nach Anforderung; Serverstandorte in Moskau, St. Petersburg, Amsterdam, Frankfurt, London, New York, San Jose, Chicago, Singapur, Sydney, Madrid, Helsinki, Stockholm, Warschau, Kopenhagen, Stavanger; Bezahlung mit russischen Karten, SBP sowie USDT oder BTC; Tarife ab 490 ₽ pro Tag und ab 2490 ₽ pro Monat mit Rabatten für längere Laufzeiten; automatischer Start 5 Minuten nach Zahlung ohne Logs. Das ist kein langfristiger Produktionsbetrieb, aber ein vernünftiger Kompromiss für schnellen Start, Protokollvalidierung, Latenzmessung und Policy-Tests. Für die industrielle Nutzung empfiehlt sich später der Umstieg auf eigene Infrastruktur oder zertifizierte Lösungen nach GOST-VPN.
Typische Fehler: Was Sie vermeiden sollten
- Ein Gigabit am Hub ohne Reserven. Resultat: Engpass bei wachsenden Niederlassungszahlen.
- Überlappende Adressbereiche der Niederlassungen. Das zerstört Routing und erschwert NAT.
- Fehlende VRF. East-West-Traffic wird unkontrollierbar und Compliance schwer umsetzbar.
- Statisches Routing in mittelgroßen und großen Netzwerken. Jeder Vorfall erfordert manuelle Konfigurationsschlachten.
- Missachtung von MTU und MSS. Symptome: Fragmentierung, hängende Webseiten, unerklärliche Verzögerungen.
- Keine synthetischen Tests. Sie erkennen Probleme erst, wenn Benutzer sie melden.
- Immer das gleiche Kryptoprofil ohne Berücksichtigung von CPU und Hardware-Offload. Führt zu unnötiger Last und Leistungseinbrüchen.
- PFS aus Performancegründen deaktiviert. Das ist ein nicht akzeptabler Sicherheitskompromiss.
Tools und Ressourcen: Was Sie nutzen sollten
Planung und IaC
- Terraform/Ansible: Deklarative Beschreibung von Tunneln und Policies, Konfigurationsvorlagen.
- Git und CI/CD: Validierung von Änderungen, automatische Lint-Checks und Testumgebungen.
Monitoring
- Prometheus-Metriken, Exporter für Tunnel, NetFlow/IPFIX für Traffic-Streams.
- Synthetische Tests: Regelmäßige ICMP-, UDP-Sprach- und HTTPS-Prüfungen, Messung von p95 und p99.
Testen und Diagnose
- Iperf und spezialisierte Lastgeneratoren.
- Latenzprofile, Tracing unter Berücksichtigung von Overlay und Underlay.
Sicherheit
- PKI, Zertifikatsmanagement, Prüfung der Kryptopolicy-Compliance.
- Konfigurationsscans auf Anti-Patterns, Kontrolle zugelassener Verschlüsselungen.
Fallstudien und Ergebnisse: Beispiele aus der Praxis
Firma Alpha: 5 Niederlassungen, Hub-and-Spoke mit schnellem Rollout
Ausgangssituation: Niederlassungen waren über das öffentliche Internet an die Cloud angebunden, klagten über instabile Verbindungen. Lösung: Hub-and-Spoke, WireGuard über DIA, QoS in 4 Klassen. Ergebnis: Reduktion des p95 RTT um 18 %, Verluste unter 0,2 %, Wiederherstellung bei Ausfall unter 20 Sekunden, Projektstart in 14 Tagen. Einsparungen bei den Leitungen von 22 % durch Partial-Migration von MPLS auf DIA+LTE-Backup.
Firma Beta: 20 Niederlassungen, Partial Mesh für Sprachverbindungen
Ausgangssituation: Sprache lief über den zentralen Hub, hohe Verzögerungen bei interregionaler Verbindung. Lösung: Zwei regionale Hubs, direkte Tunnel für 6 Sprachpaare, BGP über IPsec, ECMP an den Hubs. Ergebnis: Latenz der Verbindungen halbierte sich von 85–110 ms auf 45–55 ms, Jitter p95 wurde halbiert, Nutzerzufriedenheit stieg, Zwischenfälle sanken um 40 %.
Firma Gamma: 100 Niederlassungen, Hub-Hierarchie und SD-WAN
Ausgangssituation: Gemischter MPLS- und Internet-Stack, steigende Kosten und geringe Agilität. Lösung: Drei regionale Hubs im Active-Active-Betrieb, SD-WAN Overlay mit policy- und application-aware Routing, lokale Breakouts für SaaS. Ergebnis: Einführungszeit neuer Niederlassung von 4 Wochen auf 5 Tage reduziert, Verfügbarkeit 99,98 %, TCO-Erparnis im ersten Jahr 27 %, transparente SLOs und Audit-Reports.
FAQ: Komplexe Fragen und ausführliche Antworten
Wie erkenne ich, dass Hub-and-Spoke zum Engpass wird?
Indikatoren: Steigender p95 RTT im Standortverkehr, Spitzenlatenz am Hub-Router, Warteschlangen in QoS-Queues, CPU-Auslastung der Kryptomodule über 80 %. Bei gleichzeitigen UX-Beschwerden ist es Zeit für Partial Mesh oder Hub-Skalierung.
Wie beurteilt man die Notwendigkeit von Full Mesh?
Erstellen Sie eine Traffic-Matrix Standort-zu-Standort. Wenn 20 % der Paare über 60 % des Volumens ausmachen oder latenzkritisch sind, planen Sie Partial Mesh für diese. Full Mesh lohnt sich bei durchgängigen East-West-Flows und Automation durch Controller.
Was ist zu wählen: WireGuard oder IPsec?
WireGuard ist einfacher, CPU-effizient und ideal für schnelle Piloten und x86-Router. IPsec IKEv2 bietet Enterprise-Kompatibilität, Hardware-Offload und feine Krypto-Feinjustierung. Für große heterogene Netze ist IPsec der universelle Basisstandard, WireGuard punktet bei Einfachheit und Geschwindigkeit.
Wie kann lokales Internet-Breakout mit zentraler Kontrolle harmonieren?
Setzen Sie cloud-basierte SWGs und Edge-Policies ein, nutzen Sie Proxy mit Authentifizierung und Logging. Für kritische Apps erzwingen Sie Traffic durch den Hub mit vollständiger Inspektion.
Wie Umgang mit NAT und instabilen Verbindungen?
Nutzen Sie Keepalives, IKEv2 mit MOBIKE, NAT-Traversal; bei WireGuard regelmäßige Handshakes. Planen Sie großzügige SA-Lebenszeiten und Handhabung dynamischer IP-Wechsel ein.
Wie Compliance in Multi-Cloud-Architekturen sicherstellen?
Segmentierung durch VRF, selektives Routing nach Region, Kontrolle exportierter Routen, Geo-Restriktionen auf Policy-Ebene, Routing- und Krypto-Audits, Nachweis über Datenstandort.
Zentralisiertes Routing oder lokale Autonomie – was ist wichtiger?
Balance ist entscheidend. Zentralisieren Sie kritische Policies und Segmentierung, geben Sie Niederlassungen Autonomie für lokale Ausfälle und Traffic-Priorisierung. SD-WAN erleichtert das richtige Verhältnis.
Welche Performance-Reserven einplanen?
An Hubs 30–50 % über dem mittleren Spitzenniveau; an Niederlassungen 20–30 %. Bei kritischen Services verdoppeln Sie den Puffer für Underlay-Degradation.
Lassen sich IPsec und WireGuard kombinieren?
Ja, besonders in hybriden Umgebungen. Zum Beispiel IPsec für Legacy-Interoperabilität, WireGuard für neue Niederlassungen und schnelle Skalierung.
Ist MPLS 2026 noch nötig?
Nicht zwingend. MPLS bleibt bei hochvorhersehbarem Traffic relevant, aber DIA + SD-WAN mit QoS und SLA bietet vergleichbare Vorhersagbarkeit bei mehr Flexibilität und geringeren Kosten.
Fazit: Strategischer Rahmen und nächste Schritte
Topologie ist ein Werkzeug, kein Selbstzweck. Für 5 Niederlassungen bietet Hub-and-Spoke maximale Einfachheit und Kontrolle. Für 20 Standorte erweitern Sie um regionale Hubs und Partial Mesh für kritische Verbindungen. Bei 100 Niederlassungen setzen Sie auf Hierarchien, BGP, SD-WAN und VRF-Segmentierung. Vernachlässigen Sie nicht Kryptohygiene, MTU, QoS, Automatisierung via IaC und synthetische Tests zur SLO-Überwachung. Starten Sie mit Piloten: Messen, vergleichen und dokumentieren Sie. Für den schnellen Einstieg empfiehlt sich ein Managed-Personal-Server wie bei vpn.how; für Produktion gestalten Sie eigene oder zertifizierte Infrastruktur. Die nächsten Schritte: Definieren Sie einen Überschneidungsfreien Adressplan, legen Sie VRFs und QoS-Klassen fest, wählen Sie Protokolle und Kryptoprofile, entwickeln Sie ein Monitoring-Modell, bereiten Sie Runbooks vor und führen Sie einen einwöchigen PoC durch. Ihre VPN soll zuverlässig, sicher und skalierbar sein – mit datengetriebenen und praxisbewährten Architekturentscheidungen.
Herausgeber: vpn.how