VPN-Kanal-Redundanz: So richtest du blitzschnelles Failover ohne Ausfallzeiten ein
VPN-Kanal-Redundanz und Ausfallsicherheit 2026: Active/Passive- und Active/Active-Modi, Umschaltzeiten, Fehlererkennung, BGP, DPD, BFD, SD-WAN, WireGuard und IPsec. Praxisnahe Checklisten, Anwendungsfälle und Kennzahlen für eine stabile VPN-Infrastruktur.
Inhalt des Artikels
- Warum vpn-kanal-redundanz 2026 so entscheidend ist
- Active/passive und active/active: was ist der echte unterschied?
- Protokolle, technologien und was hinter den kulissen läuft
- Wie man probleme erkennt und wann man umschaltet
- Umschaltzeiten: welche werte heute erreichbar sind
- Praxis-architekturen: vom zweigstelle bis zur cloud
- Checklisten für die konfiguration: nichts vergessen
- Tests und betrieb: aus fehlern lernen ohne panik
- Geld, lizenzen, ökonomie der ausfallsicherheit
- Häufige fehler und wie du sie vermeidest
- Praxisfälle und zahlen aus dem feld
- 30-tage-implementierungsplan
- Trends 2026: was in 1–3 jahren zählt
- Mini-guides und praktische tipps
- Faq: kurz & knapp
Warum VPN-Kanal-Redundanz 2026 so entscheidend ist
Die Realität: Clouds, SaaS und neue Ausfallstellen
Wir leben alle in einer Welt, in der Clouds längst keine Modeerscheinung mehr sind, sondern zur Basisinfrastruktur gehören. E-Mail, CRM, ERP, Abrechnung, Code-Repositories, CI/CD, Telefonie – all das läuft über das Internet. Und wenn dein VPN wackelt, gerät auch dein Business ins Schwanken. Eine einfache Sache: eine IKEv2-Sitzung hängt 15 Sekunden – und Chatnutzer, Anrufe sowie Terminal-Sessions brechen zusammen. 2026 kostet eine "Stille Minute" im Netzwerk mehr als noch 2019 gedacht.
Der Traffic ist gestiegen, die Abhängigkeit von SaaS ebenso, und die Zahl der Remote-Mitarbeiter wächst. Früher konnte man seltene Tunnel-Neustarts überstehen. Heute sind sie ein Schlag gegen SLA und Reputation. Also braucht es einen durchdachten Plan für VPN-Kanal-Redundanz und ein klares Failover-Szenario – und zwar systematisch und messbar, nicht nur „irgendwie“.
Business-Sprache: SLA, SLO und Kosten von Ausfallzeiten
Welche Kennzahl rettet dich? SLA und SLO. Wir setzen Verfügbarkeitsziele (z.B. 99,95 %) und übersetzen sie in Ausfallzeitbudgets – Minuten pro Monat. Dann kalkulieren wir, was eine Ausfallminute im Vertrieb, Lager oder Contact Center kostet. Die Zahlen überraschen oft. Schon 300 ms Tunnel-Flapping zur Hauptverkehrszeit können Dutzende Zahlungen verhindern. Daher muss das Netzwerk nicht nur „funktionieren“, sondern bei jedem Provider-Huster „schmerzfrei umschalten“.
Typische Topologien und ihre Schwachstellen
Klassiker: Hub-and-Spoke mit zentralem Rechenzentrum oder Cloud, Full-Mesh zwischen großen Standorten, Hybrid mit SD-WAN und mehreren Internetprovidern sowie LTE/5G als eiserne Notfall-Backups. Schwachstellen? Häufig laufen Routing, NAT, Verschlüsselung und Sicherheitsrichtlinien an einer Stelle zusammen. Ein Bug oder falscher Timer – und der Kaskadenausfall ist da. Die Lösung: Redundanz auf mehreren Ebenen – Internetzugang, Routing, Tunnel, Kryptoprofile, sogar DNS und Zertifikate.
Active/Passive und Active/Active: Was ist der echte Unterschied?
Erklärungen auf den Punkt
Active/Passive bedeutet: Ein Kanal führt, der andere schweigt still und wartet. Fällt der Hauptkanal aus, übernimmt der Reservekanal. Active/Active heißt: Beide Kanäle sind aktiv, wir verteilen Lasten, balancieren und beschleunigen – wie zwei Flugzeugtriebwerke. Wichtig ist, sie synchron zu halten und keine Routing-Asymmetrie entstehen zu lassen.
Vor- und Nachteile der Ansätze
Active/Passive ist simpel, kostensparend beim Traffic und vorhersehbar. Nachteile: Umschaltungen sind immer nötig, was kurzfristige Session-Abbrüche mit sich bringt. Außerdem steht die Reserve brach und „verfällt“, wenn man sie nicht testet. Active/Active bietet höhere Durchsatzraten, schnellere Reaktionen auf Störungen und oft geringere Latenzen. Nachteile: komplexere Konfiguration, höhere Anforderungen an Routing und Monitoring. Und ja, man muss mit Asymmetrie und MTU-Problemen umgehen können.
Wann was wählen
Wenn absolut kein Hänger tolerierbar ist, wählst du Active/Active mit durchdachtem Pfad-Management (ECMP, BGP, App-Aware-Policies). Bei wenig Traffic, aber hohem Anspruch an Zuverlässigkeit und begrenztem Budget hilft Active/Passive. Hybride Situationen kommen vor: Für kritische Anwendungen Haupt- und Reservekanal als Active/Passive, für Bulk-Traffic parallel ein Active/Active-Cloud-Setup. Hybrid ist okay, solange die Kennzahlen im Blick bleiben.
Protokolle, Technologien und was hinter den Kulissen läuft
IPsec/IKEv2, WireGuard, SSL VPN: Wo sie stark und schnell sind
IPsec mit IKEv2 ist ein ausgereifter Standard, unterstützt Hardware-Beschleunigung, Enterprise Firewalls, VRF, NAT-T, MOBIKE und strikte Verschlüsselungsrichtlinien. WireGuard steht für Minimalismus und Geschwindigkeit, schnelles Neuzusammenbauen der Tunnel, einfache Schlüssel, top Performance auf ARM und x86. SSL VPN/DTLS wird oft für Clientzugänge und B2B über 443/UDP genutzt und passiert NAT sehr flexibel. 2026 sehen wir häufig Hybridlösungen: Site-to-Site per IPsec, Mitarbeiterzugriff via WireGuard oder SSL, SD-WAN-Oberflächen auf IPsec/DTLS/QUIC-Basis.
QUIC und MASQUE: Die neue Normalität für Tunnel
QUIC baut auf UDP mit integrierter Verschlüsselung und Verbindungskontrolle auf. Er ist robust gegen Paketverluste, multiplexed Streams ohne Head-of-Line-Blocking und managt Staus elegant. MASQUE ermöglicht Tunnel über HTTP/3, getarnt als normaler Webtraffic. Für Failover ist das Gold wert: Umschaltung ist schneller, Sessions leiden weniger, Degradation läuft sanfter. Traditionelles IPsec zieht nach – oft mit ähnlichen Ergebnissen, aber QUIC-Overlays punkten bei instabilen Last-Mile-Verbindungen.
Timer und der „Puls“ der Tunnel: DPD, Keepalive, BFD
Der Hauptzauber für rasantes Failover sind richtig gesetzte Timer. DPD in IKEv2 ist standardmäßig zu „nachsichtig“: 10–30 Sekunden. Für 2026 eine Ewigkeit. Aggressive Werte sind gefragt: 2–3 Sekunden Intervall, 2–3 Versuche, maximal 4–9 Sekunden Erkennung. WireGuard? Keepalive alle 15–20 Sekunden für NAT-Passage plus parallele Health-Checks auf SD-WAN-Ebene. Der schnellste Detektor ist BFD. Es ist nicht an ein spezifisches VPN-Protokoll gebunden und reagiert bei guter Konfiguration in 150–300 ms, vor allem mit Hardware-Offload. In Verbindung mit BGP ermöglicht es sekundenschnelles Routing.
Wie man Probleme erkennt und wann man umschaltet
Health-Kennzahlen für den Kanal
Nicht nur Link-Up/Down. Wir beobachten RTT, Jitter, Paketverluste, MOS für Sprachdienste, TCP-Retry, HTTP-Fehlerraten. In SD-WAN-Policies kann das heißen: Wenn Verlust > 2 % über 5 Sekunden oder Jitter > 30 ms, wird VoIP auf den alternativen Pfad umgeleitet. Für Videokonferenzen noch strenger. Für Bulk-Traffic tolerieren wir bis zu 5–7 % Verlust, aber nicht länger als 10 Sekunden.
Synthetische Tests und smarte Routenwahl
Pings zu mehreren Zielen, HTTP/HTTPS-Tests an realen SaaS-Diensten, DNS-Tests und sogar Transaktionen auf Anwendungsebene (Login-Anfragen an CRM). Warum? Ein Provider kann „Link Up“ melden, während Traffic über überlastete Transitwege läuft. Wir prüfen genau den Pfad zu wichtigen Services, nicht den abstrakten „Internet“-Status. Stark ist auch App-Aware-Routing im SD-WAN: Sprache nutzt immer den besten Pfad, während Backup-Traffic auf langsamer LTE-Strecke bleibt.
Umschaltkriterien und Anti-Flapping
Wichtig ist, nicht hin und her zu springen. Wir setzen Hysterese: z.B. 3 Sekunden stabile Degradierung führen zum Umschalten, 15 Sekunden stabile Verbesserung zum Zurückschalten. Eine „leichte Bevorzugung“ des Hauptkanals verhindert endloses Hin-und-Her-Pendeln. Und ja, die tatsächlichen Kennzahlen landen im Monitoring, um Entscheidungen nachvollziehbar zu machen.
Umschaltzeiten: Welche Werte heute erreichbar sind
Reale Bereiche
Ein Szenario mit IPsec/IKEv2 und aggressiven DPD: 1–3 Sekunden Erkennung plus 0,5–1,5 Sekunden Pfad-Neubau, insgesamt 1,5–4,5 Sekunden. Schneller geht’s? Ja. BGP + BFD erreicht 150–300 ms Erkennung, 100–400 ms Konvergenz – also 250–700 ms. QUIC-Overlay auf SD-WAN mit Per-Flow-Migration schafft 150–400 ms für die meisten Anwendungen und fällt Nutzern kaum auf.
Wo die Verzögerungen stecken
Verschlüsselung bremst kaum, wenn Hardwarebeschleunigung vorhanden ist. Die Control Plane bremst: langsame Timer, schwere ACLs, Routing-Asymmetrie, mehrfaches NAT, IPS/IDS-Neustarts sowie DNS und Applikationsclients (z.B. SIP verzögert Umschaltung). Häufig sind Cross-Module-Prüfungen in Firewalls für 0,5–1 Sekunde Verzögerung verantwortlich, falls nicht schnelle Zustandswiederherstellung aktiviert ist.
Feinjustierung für Sub-Sekunden
Möchtest du „kaum spürbar“? Dann BFD für BGP/OSPF einschalten, ECMP mit Flow-Hashing, State-Sync im Firewall-Cluster, QUIC für latenzkritischen Traffic, vorgewärmte IPsec-Sicherheitsassoziationen (Rekey im Voraus, nicht bei Ausfall). Und teste live, nicht nachts in Ruhe.
Praxis-Architekturen: Vom Zweigstelle bis zur Cloud
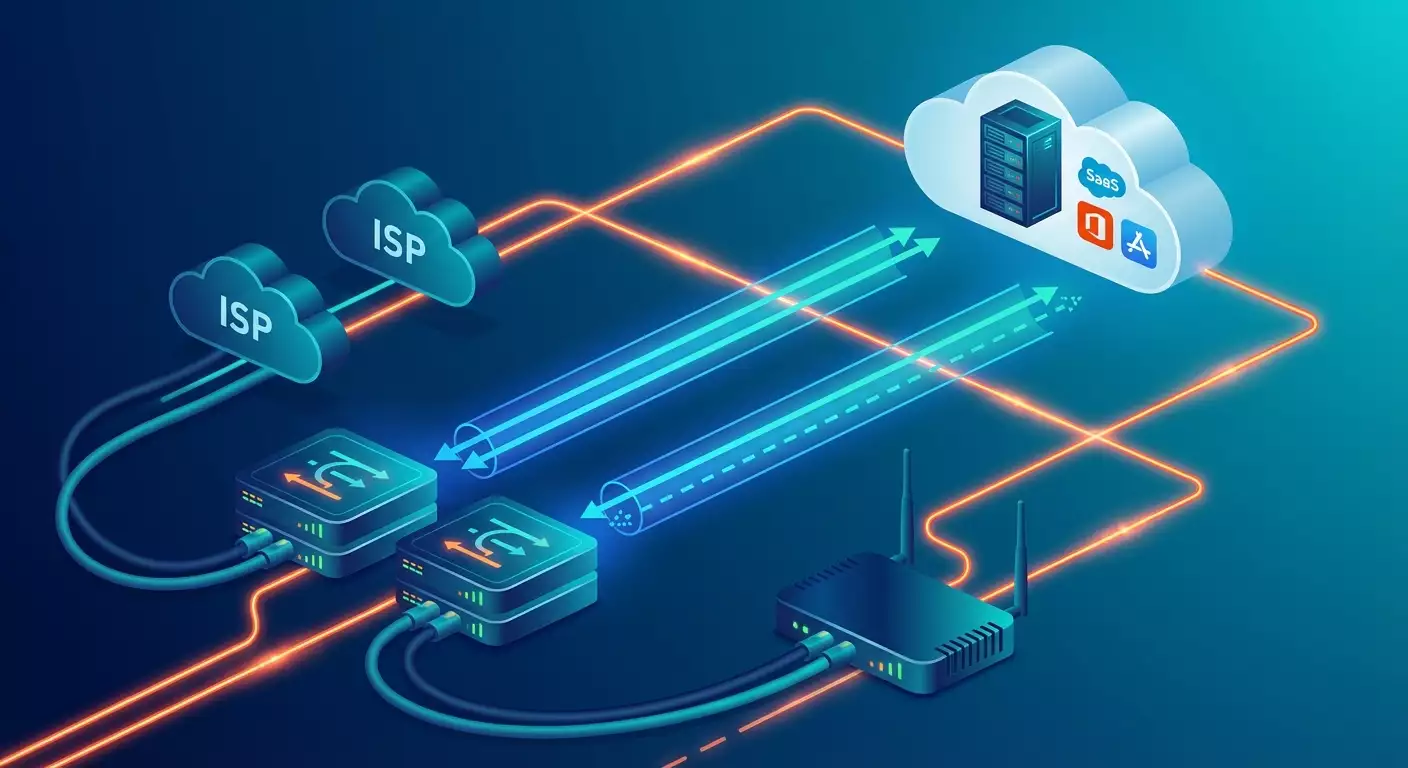
Zwei Provider plus LTE/5G als Versicherung
Goldstandard für Filialen: Zwei feste Provider (z.B. Glasfaser und FTTB) plus drittes Bein per LTE/5G. Feste Leitungen laufen Active/Active für Traffic-Distribution, Mobilfunk bleibt als passive Notfalllösung. Prioritäten setzen: Sprache und ERP fallen nie aufs Mobilfunknetz – außer Katastrophenfall. Große Dateien gehen gar nicht darüber. Rechnungen für Traffic freut es.
Hub-and-Spoke mit Cloud-Zentrum
Liegt das Zentrum in der Cloud, gibt es doppelte Zugänge: IPsec zu zwei Regionen desselben Providers oder zu verschiedenen Clouds (Multi-Cloud) mit Anycast-Adressen für Entry-Points. BGP über IPsec aktiviert, BFD zugeschaltet, am Ende Firewall-Cluster mit VRRP/HA. Klingt komplex, bringt aber Sekunden-Failover zwischen Regionen statt Minuten.
Vollwertiges SD-WAN für globale Unternehmen
SD-WAN bietet App-Aware-Policies, flexible Telemetrie, Overlay-Aufbau über jede Underlay-Verbindung: MPLS, DIA, LTE/5G, sogar LEO-Satelliten. 2026 unterstützen viele Hersteller nativ QUIC und MASQUE, NBAR2-App-Erkennung, SLA-Management für hunderte Präfixe. Wichtig: Kontrolle behalten. Wir dokumentieren genau, welcher Traffic wohin geht, unter welchen Bedingungen umgeschaltet wird, und führen Degenerationstests regelmäßig durch.
Checklisten für die Konfiguration: Nichts vergessen
Planung und Adressierung
Netz-Segmentierung und VRF im Voraus, um Fehler im Produktivsystem zu vermeiden. IP-Subnetzplan, kritische Anwendungen, SLA-Prioritäten nach Klassen (Sprache, Video, Transaktionen, Backups). MTU und MSS definieren, Path-MTU-Discovery prüfen, 60–80 Byte für Verschlüsselungsoverhead einplanen (je nach Protokoll und Optionen).
Routing und Richtlinien
Entscheide dich für statisches oder dynamisches Routing (BGP/OSPF). Bei zwei Pfaden BGP + BFD verwenden. ECMP für Active/Active aktivieren. Für Active/Passive Präferenzen und Gewichtungen anpassen. Policy-basiertes Routing ergänzen, wenn IP-Adressen nicht ausreichen, aber Anwendungen bekannt sind.
Timer, Healthchecks und Failback
DPD 2–3 Sekunden, 2–3 Versuche. BFD 200/200/3 (z.B. 200 ms Interval, 3 Fehlschläge). Anti-Flap-Timer 10–20 Sekunden für Rückkehr. Getrennte SLA-Schwellen für Sprache/Video und Bulk. Sinnvoll: synthetische HTTP-Tests an realen Services anstatt nur ICMP pings zu 8.8.8.8.
Monitoring und Protokollierung
NetFlow/IPFIX aktivieren und in NTA/NPM exportieren, Metriken mit Prometheus sammeln, Traces mit OpenTelemetry, Alerts per Chatbot. Umschaltungen, Gründe, Dauer und betroffene Trafficklassen protokollieren. Ohne das optimierst du blind – und das tut weh.
Tests und Betrieb: Aus Fehlern lernen ohne Panik
Playbooks und SLO
Definiere SLOs für Detection Time (TTD) und Recovery Time (TTR). Erstelle Playbooks: Wer tut was bei Degradation, welche Befehle prüft man, was startet man neu, wen informiert man. Ein einfacher Checklisten-Plan spart oft Zeit und Geld.
Chaos-Tests während der Arbeitszeit
Ein bisschen beängstigend, aber effektiv. Geplante Degradations-Simulationen: Wir erhöhen Verlust auf 3 % am Hauptkanal und prüfen, ob Sprache auf Alternativpfad wechselt. Ein Unterlay ausschalten und testen, ob Sessions erhalten bleiben. Bitte nicht freitags abends – aber regelmäßig durchführen.
Postmortem ohne Schuldzuweisung
Nach einem Vorfall analysieren wir, was wirklich passierte: Welche Timer griffen, was bremste, wo hätte man schneller reagieren können. Kleinigkeiten korrigieren, Lessons Learned dokumentieren. Netzwerk ist ein lebender Organismus. Perfekte Konfiguration beim ersten Mal gibt es nicht – und das ist okay.
Geld, Lizenzen, Ökonomie der Ausfallsicherheit
CAPEX und OPEX verständlich erklärt
Zwei Provider, plus LTE/5G, plus SD-WAN- oder VPN-Gateway-Lizenzen wirken teuer. Aber wir rechnen TCO gegen Ausfallkosten. Oft amortisiert sich ein einziger ernsthafter Vorfall bereits innerhalb eines Jahres Lizenzkosten. Und wenn du wegen VPN-Ausfall Lieferanten mit Papierkurieren losschickst – ist der Buchhalter-Albtraum vorprogrammiert.
Wo sparen – und wo nicht
Spar nicht am Monitoring und an Reserve-SIM-Karten. Spar an überflüssigen Features, die du nie nutzt (z.B. Layer-4 DPI, wenn NTA schon da ist). Tarife für Mobilfunk genau vergleichen und Bursts bei Ausfällen einkalkulieren.
Lizenzen und versteckte Limits
Viele Hersteller limitieren Anzahl der Tunnel, BFD-Sessions, App-Aware-Policies. Check die Tabellen vor Kauf, sonst fliegt die schöne Theorie im Live-Betrieb. Kläre auch, ob QUIC/HTTP3 und MASQUE in deiner Software-Edition enthalten sind – 2026 ist das oft Standard, aber nicht überall automatisch an Bord.
Häufige Fehler und wie du sie vermeidest
MTU, MSS und Fragmentierung
Top 1 Ursache für seltsame Bugs. Tunnel addieren Overhead, MTU sinkt, Pakete splitten, Apps meckern. Setze MSS Clamp auf 1360–1380 bei TCP über IPsec/SSL, teste PMTUD, achte auf das DF-Bit. Lieber einen Abend in Tests stecken als eine Woche nach Phantomfehlern suchen.
Routing-Asymmetrie und Stateful Firewall
Active/Active ist super, aber Asymmetrie kann tödlich sein. Wenn der Eingang über eine Leitung und der Ausgang über eine andere läuft, kann die Stateful Firewall droppen. State-Sync in Clustern aktivieren, Per-Flow ECMP nutzen, Hashing (5-Tupel) überwachen und unerwartete PBR-Ausnahmen vermeiden.
Default-Timer
Defaults sind keine Freunde. DPD mit 10–30 Sekunden, BGP ohne BFD, DNS TTL von einer Stunde – all das macht Failover träge und schmerzhaft. Aggressiv aber mit Anti-Flap konfigurieren. Szenarien vorher durchspielen. Wir kaufen ja auch keinen Sportwagen und lassen den Tempolimiter auf 40 km/h.
Praxisfälle und Zahlen aus dem Feld
Einzelhandel: 200 Filialen, LTE als Rettungsschirm
Ein Filialnetz stieg um auf Dual DIA + LTE/5G als Backup. Für POS und Acquiring galt striktes SLA (Verlust < 1 %, RTT < 120 ms). Umschaltung auf LTE erfolgt in 1–2 Sekunden, Zahlungen brechen nicht ab, maximal eine Autorisierungsverzögerung von 0,3–0,5 Sekunden. Traffic-Kosten stiegen um 8 % jährlich, Ausfallzeiten der Kassen sanken um 92 %.
SaaS-Entwickler: globales SD-WAN und QUIC
RnD-Team arbeitet aus 6 Ländern. SD-WAN mit QUIC-Overlay für Git, CI/CD und Videocalls eingeführt. Umschaltung zwischen Backbones dauert 150–300 ms, Transitprovider-Ausfall in Europa fiel Nutzern nur in Grafiken auf, nicht in der Anwendung. Beschwerden über „Lag“ sanken um 40 %, nur durch richtig gesetzte Policies und Schwellenwerte.
Callcenter: BGP + BFD für Sprache
400 Agenten nutzen VoIP und Thin Clients. Vor BFD betrug Umschaltung 6–8 Sekunden, was Anrufe unterbrach. Danach 200–400 ms. Großteil der Arbeit war das Säubern der QoS-Marken und Anti-Flap-Konfiguration, nicht das „magische“ Hardware-Upgrade.
30-Tage-Implementierungsplan
Woche 1: Inventarisierung und Ziele
Liste der Provider, Tunnel, Adresspläne, Anwendungen und Metriken erstellen. SLO definieren: für Sprache TTR max. 1 Sekunde, für Web 3 Sekunden, für Backups 30 Sekunden. Verantwortlichkeiten klären.
Woche 2: Pilot und Timer
Pilot an zwei Standorten aufbauen: BFD aktivieren, DPD reduzieren, ECMP oder Active-Reserve konfigurieren. NetFlow, synthetische HTTP-Tests und Chat-Alerts einschalten. Degradations-Simulation mit Loss/Jitter durchführen, Umschalt-Graphen und Logs auswerten.
Woche 3: Sicherheit und Cluster
State-Sync in Clustern, korrektes NAT, IPS/IDS schärfen, unnötige Checks bei Failover Traffic vermeiden. Kryptoprofile updaten (AES-GCM, PFS, Key-Attestierung), Hybrid Post-Quantum-Profile prüfen, falls Vendor IKEv2 PQC-Hybrid bietet.
Woche 4: Skalierung und Prozesse
Rollout auf alle Standorte, Playbooks dokumentieren, regelmäßige Degenerationstests etablieren, Berichte für CFO/CIO einrichten: Anzahl Umschaltungen, Zeitvorteil, gerettete Anrufe und Transaktionen. Das ist mehr als nur Netzwerk – das ist Business-Tool.
Trends 2026: Was in 1–3 Jahren zählt
Massenakzeptanz von QUIC und MASQUE
Immer mehr Vendoren ermöglichen Tunnel über HTTP/3. Verpackung unter 443/UDP ist durchlässig und flexibel bei Degradation. Wir sehen gemischte Szenarien: IPsec für B2B, QUIC-Overlay für Sprache und Video.
App-Aware wird tiefer
SD-WAN erkennt nicht nur Anwendungen, sondern deren Phasen: Signalling, Medienströme, Daten. Policies werden klüger, Umschaltungen feiner, unnötige Migrationen seltener. Das spart auf Backup-Kanälen Geld und erhöht die Stabilität.
Postquantum-Algorithmen in IKEv2
Hybrid-Handshakes erscheinen schon in Enterprise-Produkten. Noch in Entwicklung, aber bald Pflicht-Checkbox für Compliance in manchen Branchen. Rechenleistung für Kryptographie einplanen.
Mini-Guides und praktische Tipps
Providerauswahl und Diversifikation
Unterschiedliche Pfade, verschiedene Entry-Points, idealerweise verschiedene Backbone-Provider. Prüfe, ob beide Provider nicht über denselben dritten Tunnel laufen. SLA mit echten Strafzahlungen fordern, nicht nur „reden wir nochmal“.
QoS und Markierung
Vom Eingangsport bis Tunnel und zurück. DSCP erhalten, sonst konkurriert Sprache beim Failover mit Backups. Rewrite im Tunnel und an NAT-Grenzen prüfen. Queue-Management gegen „böse“ große Warteschlangen einschalten.
Dokumentation ohne Qual
Eine Seite pro Service: SLA-Ziele, kritische Abhängigkeiten, Backup-Pfade, Timer, Providerkontakte. Vierteljährlich aktualisieren. Niemand mag Doku, aber wenn es mal brennt, ist sie der Rettungsschirm.
FAQ: Kurz & knapp
Was ist eine „gute“ Umschaltzeit für VPNs 2026?
Für Sprache und Video peilen wir 150–700 ms (BFD, ECMP, QUIC) an. Für normale Webanwendungen sind 1–3 Sekunden okay. Über 5 Sekunden merken Benutzer und klagen.
Ist Active/Active immer besser als Active/Passive?
Nein. Es ist komplexer, teurer im Betrieb und verlangt gutes Routing und Firewall-Staat. Wenig Traffic und knappes Budget werden mit gut konfiguriertem Active/Passive und aggressiven Timern oft schlicht besser bedient.
Gibt es schnelles Umschalten mit „nacktem“ IPsec ohne SD-WAN?
Ja. BGP + BFD über IPsec, korrekte DPD, aggressive Rekeys, State-Sync, ECMP – so landest du bei sub-sekündigen Failovers für die meisten Use Cases. SD-WAN bringt Komfort und App-Aware, ist aber kein Muss.
Soll man Reservekanäle immer voll belasten?
Teilweise ja. Es läuft Health Traffic und etwas Nutzlast, damit der Kanal nicht „einrostet“. Völlig leerer Backup-Kanal überrascht oft zum ungünstigsten Moment.
Woran erkenne ich, dass Umschaltung Nutzer kaum stört?
Nicht nur RTT/Loss messen, sondern Nutzer-KPIs: Ladezeiten, Transaktionserfolge, MOS, Jitter. Plus Umfragen, NPS, Ticketanalysen. Nur das Zusammenspiel aller Daten gibt ein ehrliches Bild.
Lohnen sich kritische Anwendungen auf QUIC umzustellen?
Wenn der Vendor es unterstützt und du testen möchtest: Ja. QUIC hilft gegen Paketverluste und schnelle Wiederherstellung. Ersetzt aber kein gutes Routing und Backup. Es ist ein Verstärker, kein Allheilmittel.
Was tun, wenn Provider über denselben Pfad laufen?
Alternativen suchen: Richtfunk, LEO-Satellit, LTE/5G. Manchmal ist das vermeintliche „Verschiedensein“ der Provider nur Illusion. Physische Diversifikation dringend einfordern.
