VPN-Lastverteilung ohne Ausfälle: Algorithmen, Health Checks und Skalierung im Jahr 2026
Lastverteilung für VPN-Server 2026: Algorithmen, Health Checks, Session Persistence, Skalierung und Ausfallsicherheit. Praktische Tipps, Metriken und Anwendungsfälle zu WireGuard, OpenVPN, IPsec und Anycast für eine stabile VPN-Infrastruktur.
Inhalt des Artikels
- Warum vpn-lastverteilung überhaupt wichtig ist – besonders 2026
- Architektur-patterns für vpn-lastverteilung: von l4 bis anycast
- Lastverteilungsalgorithmen: von einfach bis fortgeschritten
- Health checks und monitoring: wir prüfen nicht nur ports, sondern tunnelqualität
- Session persistence für vpn: so hältst du deine clients „fest“
- Vpn-skalierung: vertikal, horizontal und „intelligenter“ auto-scaling
- Sicherheit und resilienz: ddos, zero trust und compliance
- Praxisbeispiele und templates für openvpn, wireguard und ipsec
- Metriken, slos und wirtschaftlichkeit: so erkennst du, dass alles läuft
- Fehler und anti-pattern: worauf man am häufigsten ausrutscht
- Schritt-für-schritt-plan für vpn-lastverteilung
- Praxisfälle: was funktioniert und was nicht
- Checkliste vor dem go-live: haben wir alles im griff?
- Faq: häufige fragen zur vpn-lastverteilung
Warum VPN-Lastverteilung überhaupt wichtig ist – besonders 2026
VPN ist längst mehr als nur „Home Office“ – es ist ein kritisches Netzwerk
Vor ein paar Jahren verband man VPN in Unternehmen vor allem mit Remote-Arbeit und Zugriff auf interne Systeme. Heute sieht das ganz anders aus. 2026 ist VPN die Grundlage für Zero Trust, hybride Clouds, Entwicklungsumgebungen, Zugriff auf KI-Cluster und Edge-Standorte. Wenn früher ein Server ausfiel, war das ärgerlich. Heute kann selbst eine kurze Downtime die CI-Pipeline stören, Transaktionen abbrechen und den NPS drücken. Die Lastverteilung für VPN-Server ist keine „Option“ mehr, sondern das Fundament deiner Netzzuverlässigkeit.
Wieso ist die Last gestiegen? Wir sehen Echtzeit-Daten aus Video-Support, IoT-Telemetrie, synchronisierten Daten für LLM-Inferenz direkt am Rand. Zudem ist VPN nicht mehr nur „TCP-Only“: WireGuard und IPsec setzen auf UDP und verlangen andere Ansätze bei Health Checks, NAT-Weiterleitungen und Sitzungsmanagement. Das Tempo ist hoch, Skalierung ohne Panik das Ziel. Oder eher nicht?
Die Kernbotschaft ist simpel: Ohne kluge Verteilung der Anfragen auf die VPN-Knoten stößt du schnell an Grenzen bei CPU, EPOLL, Sockets und State-Tabellen. Der Load Balancer ist der Dirigent deines VPN-Orchesters – er sorgt dafür, dass keine Leitung aus dem Takt gerät und alles den Peak-Lasten standhält.
Typische Überlastungsanzeichen, die du sicher schon erlebt hast
Das kennst du sicher: Beim Lastpeak springen die Ping-Zeiten, die Bandbreite sinkt. Einzelne Nodes erreichen CPU-Auslastungen von 90–100 %, während andere daneben quasi untätig bleiben. Nutzer klagen über ständige Reconnects, WireGuard-Peers „verschwinden“ minutenweise, OpenVPN-Logins verzögern sich durch TLS-Handschläge. Das ist das klassische Bild einer ungeschickten Lastverteilung, bei der ein Knoten die ganze Last trägt und die anderen nichts zu tun haben.
Dazu kommen DDoS-Angriffe über UDP, plötzliche Lastspitzen nach Releases oder Arbeitsbeginn und schwankende Routing-Pfade in Multi-Cloud-Topologien. Ohne eine passende Architektur verlierst du SLA und Geld. Und das Ironischste: Oft lösen nicht teure Hardware-Updates das Problem, sondern clevere Algorithmen und Health Checks – also quasi kostenlos, aber rechtzeitig und sauber.
Was sich bis 2026 geändert hat: Neue Trends und Realitäten
DPU/SmartNICs, eBPF/XDP-Offload, Anycast+BGP am Perimeter, Cross-Region-L4-Load-Balancer mit Millionen Paketen pro Sekunde sowie automatisches Skalieren anhand realer Session-Metriken sind Alltag geworden. Wir setzen verstärkt auf Maglev und Ring-Consistent Hashing, realisieren UDP-Stickiness auf 5-Tuple- oder Peer-ID-Ebene und nutzen Session Resumption für TLS, IPsec und IKEv2. Post-Quanten-Algorithmen stehen in Pilotprojekten; die Kryptografie wird komplexer. Und alle wollen „Skalierung im minimalistischen Stil“: weniger komplizierte Hacks, mehr Vorhersehbarkeit und Automatisierung.
Architektur-Patterns für VPN-Lastverteilung: Von L4 bis Anycast
Klassiker: L4-Load Balancer vor den VPN-Nodes
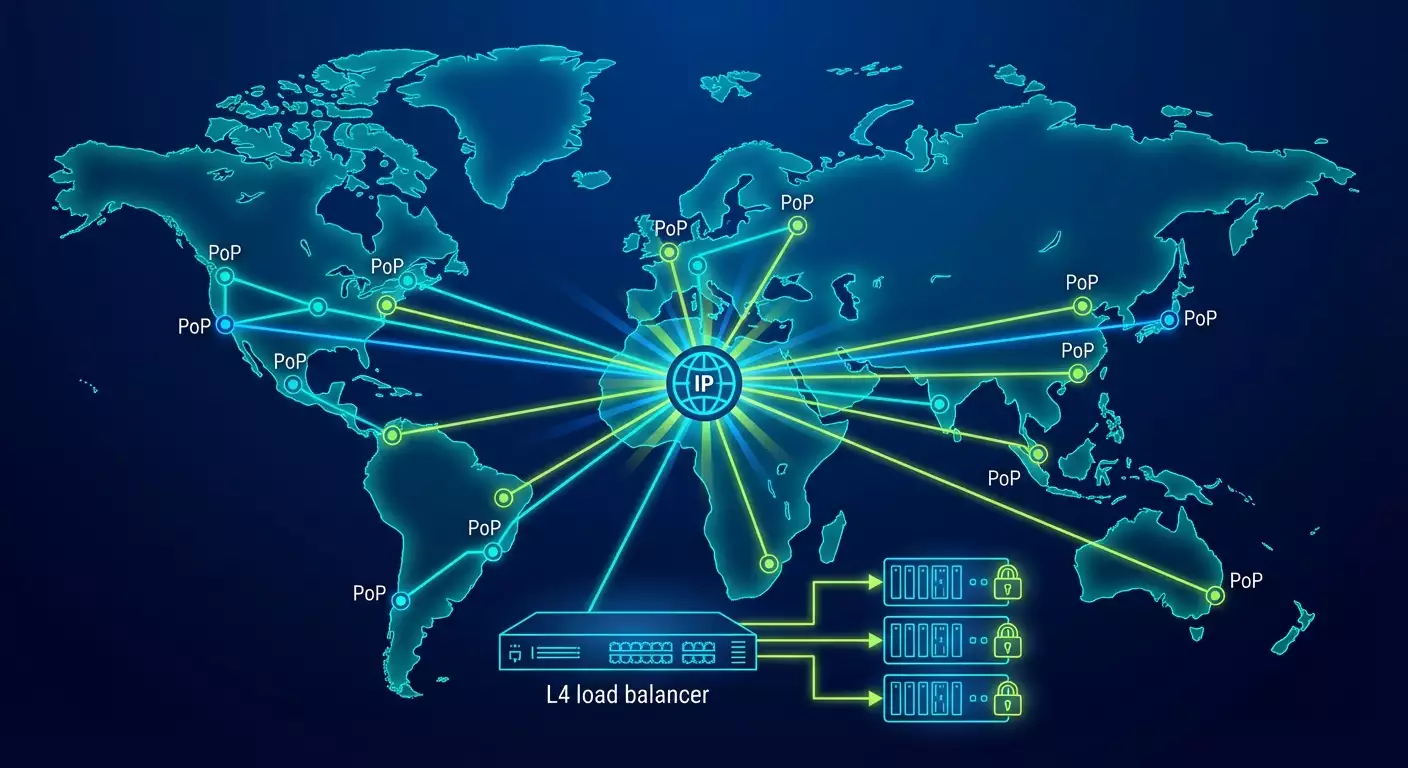
Die einfachste Variante ist ein L4-Load Balancer vor dem Pool der VPN-Server, der eingehende Verbindungen annimmt und auf die Nodes verteilt. Für OpenVPN (TCP oder UDP), WireGuard (UDP), IPsec/IKEv2 (UDP 500/4500) ist das eine bewährte Architektur. Vorteile: zentrale Kontrolle, Health Checks, einfache Auto-Skalierung. Nachteil: potenzielle Single Point of Failure und die Herausforderung, Sticky Sessions besonders bei UDP korrekt umzusetzen.
In der Praxis verwendet man HAProxy, Nginx Stream, Envoy (L4/L7), kommerzielle und Cloud-native Network Load Balancer mit direktem Forwarding. Entscheidend ist, symmetrische Pfade zu garantieren und den „Flow“ auf einem Node zu halten. TCP ist einfacher: stabile Sessions. UDP erfordert Hashing von Quell- und Ziel-IP, damit Tunnel intakt bleiben. Bei großen Datenmengen wird ECMP mit Feineinstellungen genutzt.
In kritischen Umgebungen setzt man auf Active-Active-Cluster mit VRRP/keepalived oder integrierter Hochverfügbarkeitslogik. Wichtig ist auch ein Out-of-Band-Monitoring, das nicht nur Port-Liveness, sondern den Gesundheitszustand der Tunnel misst.
Anycast+BGP am Perimeter für globale PoPs
Betreibst du mehrere Regionen oder PoPs, ist Anycast fast schon Magie. Dieselbe IP wird über BGP von unterschiedlichen Standorten angekündigt, sodass Nutzer vom netznächsten PoP bedient werden. Das bringt minimale Latenz und geographische Verteilung aus der Box. Im PoP verteilt man den Traffic dann an L4- oder DPU-Load-Balancer. So erreichst du CDN-ähnliche Nutzererfahrungen.
Anycast erfordert aber sorgfältiges Management von Route-Flapping, korrekten Prepends und Community-Attributen für Prioritäten und – besonders wichtig – zuverlässiges Failover. Wenn ein PoP ausfällt, müssen die Routen schnell zurückgezogen werden. Wir haben Fälle mit Konvergenzen unter 30 Sekunden bei Ausfällen und unter 5 Sekunden intern im L4-Bereich bei Health Failure erlebt – Benutzer merken fast nichts.
Direct Server Return und Forwarding ohne Kopien
Für maximale Durchsatzleistung wird DSR oder ähnliche Techniken verwendet: Eingehender Traffic läuft über den Load Balancer, Ausgangstraffic geht direkt vom Server zum Client – am Load Balancer vorbei. Das entlastet den Balancer, erfordert aber komplexere Netzwerkkonfiguration. Im VPN-Bereich eher selten, da State und Verschlüsselung konsistent bleiben müssen. Bei Hochleistungs-IPsec-Gateways in Rechenzentren ist DSR mit symmetrischem Routing aber durchaus praktikabel.
Wichtig: DSR erschwert das Debugging, Tunnel-Diagnosen müssen transparent sein. Wenn dein Team nicht bereit ist, ist der klassische L4-Load Balancer mit guter Skalierbarkeit und aussagekräftigen Metriken die sicherere Wahl.
Lastverteilungsalgorithmen: Von einfach bis fortgeschritten
Round Robin, Weighted RR und warum das oft nicht reicht
Round Robin ist schnell und simpel. Doch es ignoriert die Realität: Nodes sind nicht gleich und die Last schwankt stark. Weighted RR hilft, wenn du Gewichtungen aufgrund von CPU, Kernen oder Verschleierungsgeschwindigkeit vergibst. Aber: VPN-Traffic ist instabil, einzelne Clients erzeugen Gigabit-Volumen, andere fast gar nichts. Verteilung nach Verbindungen sagt wenig über tatsächliche Last. Es braucht also einen intelligenteren Ansatz.
Im Alltag ist Weighted RR oft Startkonfiguration. Später wird Telemetrie und dynamische Gewichtsanpassung genutzt: Z.B. sinkt das Node-Gewicht bei 75 % CPU um 20 %, bei 85 % um 50 % usw. Diese Adaptivität ist nicht perfekt, dämpft aber Lastspitzen wirkungsvoll.
Least Connections / Least Load und adaptive Metriken
Least Connections passt gut zu TCP-basierten VPNs (OpenVPN-TCP), da sich aktive Verbindungen gut mit Last korrelieren. Für UDP-Tunnel (WireGuard, IPsec) messen wir aktive Peers und Paketraten (PPS/BPS). Die neue Metrik „effektive Sessions“ gewichtet Clients entsprechend ihres tatsächlichen Traffics in den letzten Sekunden. Der Balancer wählt dann den Knoten mit der geringsten effektiven Last – daher der Begriff Least Load.
2026 ist das Standard: Beim Hinzufügen neuer Peers entscheidet man anhand von CPU, IRQ-softnet, PPS, BPS, drop/queue sowie der Anzahl aktiver SAs (IPsec) oder Peers (WireGuard). Die Daten kommen aus eBPF, Netlink oder Prometheus-Exporter und werden alle 1–3 Sekunden aktualisiert. Metrik-Fluktuationen filterst du am besten mit exponentiellem Glätten.
Consistent Hashing, Maglev und UDP-Stickiness
Das große Problem bei UDP: Keine klassischen Sessions wie bei TCP, aber Tunnel-State ist da. Du brauchst eine „Klebung“ der Zuordnung – ein Client sollte beständig zum gleichen Knoten geleitet werden. Sonst wird der Tunnel ständig neu aufgebaut, Pakete gehen verloren und der Nutzer ist frustriert. Hier nutzt man Consistent Hashing auf 5-Tuple-Basis, über die Quell-IP oder eindeutige Client-IDs. Maglev- und Ring-Consistent Hashing halten die meisten Clients bei Änderungen im Cluster stabil auf ihrem Knoten.
Praktischer Tipp: Bei CGNAT auf Kundenseite schwankt die Quell-IP. Dann greif lieber auf beständige Schlüssel zurück, z.B. Client-Zertifikats-CN (OpenVPN), Peer Public Key (WireGuard) oder Identity aus RADIUS/AAA. Der Balancer braucht eine unveränderliche Entität, sonst wird die Stickiness instabil und Tunnel wandern bei jeder Wiederverbindung.
Health Checks und Monitoring: Wir prüfen nicht nur Ports, sondern Tunnelqualität
Passive und aktive Checks
Ein einfacher TCP- oder UDP-Port-Check ist Basis, reicht aber nicht. Aktive Prüfungen umfassen Handshake-Überwachung für OpenVPN/TLS, IKE_SA bei IPsec, Ping über Tunnel-Interface oder Testpakete für WireGuard. Ein guter Health Check testet nicht nur, ob der Dienst lebt, sondern ob ein Test-Peer erfolgreich einen verschlüsselten Austausch macht. Klingt komplexer, hilft aber, „leblose“ Prozesse mit defekter Routing-Logik zu erkennen.
Ergänzend tracken wir passive Telemetrie: Paketverluste, wachsende qdisc-Warteschlangen, Kryptografiefehler, Handshake-Fehlerraten und Latenz im P95/P99-Bereich. Überschreitet z.B. P99 200 ms in regionalen PoPs oder liegt die Drop-Rate über 0,1 %, gibt’s Alarm. Schwellenwerte definierst du je nach SLO. 2026 akzeptieren wir das als Standard – keine Diskussion mehr.
Multikaskadierte Prüfungen und „Netzwerk“ aus Checks
Ein einzelner Health Check ist schwacher Schutz. Wir bauen Kaskaden: schnelle L4-Pings alle 2 Sekunden, erweiterte Funktionstests alle 10–20 Sekunden und synthetische Transaktionen (z.B. kurze Verbindungs-Testläufe mit Client-Imitation) jede Minute. Über die Mehrzahl der Signale entscheidet das Entfernen eines Knotens aus dem Pool – so verhindern wir sinnlose Ausfälle durch Fehlalarme. Das Zurückholen funktioniert ebenfalls kaskadiert mit Hysterese.
Zudem geben unabhängige Vantage Points aus unterschiedlichen ASN externe Checks – sie prüfen Anycast-Knoten und messen Reallatenz. So entgehst du Situationen, in denen intern alles grün ist, Nutzer aber wegen Providerproblemen oder MTU-Fehlern leiden. Wir hatten Fälle, in denen ECMP Traffic abschneidet, aber das interne PoP grün leuchtet – nur externe Tests zeigten die Wahrheit.
Fehlalarme und Debounce
Fehler passieren: UDP-Pakete gehen verloren, CPU spikes sind kurz, Garbage Collection verzögert Tests. Nutze Debounce-Mechanismen: N fehlgeschlagene Checks hintereinander, Beobachtungsfenster, exponentielle Intervalle. Logge nicht nur das Ereignis selbst, sondern auch Kontext wie Metriken, Auslastung und Konfigurationsänderungen. Die Nachanalyse ist dein kostenloses Upgrade für Stabilität.
Session Persistence für VPN: So hältst du deine Clients „fest“
Sticky über 5-Tuple, Quell-IP und Benutzer-ID
Basis ist Sticky nach 5-Tuple: src IP, src Port, dst IP, dst Port, Protokoll. Für TCP ist das passend. UDP-Ports können wechseln, daher sind stabilere Schlüssel besser. OpenVPN nutzt Client-CN aus Zertifikat oder Nutzername aus RADIUS, WireGuard den öffentlichen Peer-Key, IKEv2 IDi/IDr oder EAP-ID. Optimal ist, wenn der Balancer diese Felder früh im Handshake lesen kann oder mit einem Controller zusammenarbeitet, der das Mapping übergibt.
Je stabiler der Schlüssel, desto weniger Migrationen, desto besser die Nutzerzufriedenheit. Niemand mag ein „springendes“ Tunnel, selbst wenn das Reconnect nur Sekunden dauert. Unsere Messungen zeigen: Ein Peer-Wechsel erhöht P99-Latenz für 1–2 Minuten um 30–60 %. Vermeide das mit gutem Sticky und Drain-Mode.
Drain-Mode, Graceful Reload und Rolling Updates
Updates sollten nicht auf Kosten der Nutzer gehen. Schalte einen Node vor Deployment in den Drain-Mode: Er akzeptiert keine neuen Clients mehr, bedient aber bestehende. Nach 5–15 Minuten (abhängig von Tunnel-Timeouts und Aktivität) wandern fast alle Sessions zu anderen Nodes. Dann erfolgt ein Graceful Restart – minimaler Unterbruch oder idealerweise nahtloses Rotieren von Worker-Prozessen. Danach wird der Node wieder in den Pool aufgenommen.
WireGuard ist bekannt für Einfachheit, aber das Neuaufsetzen des Interface löscht meist Peer-State. Updates daher vorsichtig: Atomare Konfigurationsanwendung, vorher geladene neue Regeln, dann Umschalten. OpenVPN profitiert von TLS Session Resumption und vermeidet Key-Wechsel bei Lastspitzen.
State Sharing und Session Directory
Wo speicherst du Zustand, wenn Migration nötig ist? Manche Architekturen verwenden Session Directories – zentraler Cache des Mappings Client → Node, zugreifbar für Balancer und Kontrollschicht. Dort wird nicht der ganze Kryptostate gehalten, aber der nächste Handshake korrekt weitergeleitet. Für IPsec gibt’s Synchronisation von Security Associations (SAs) zwischen aktiven Nodes. 2026 existieren Produkte und Open-Source-Lösungen, die SA teilweise replizieren oder beim Failover schnell wiederherstellen. Vollständige Replikation ist selten nötig; meist reicht ein schnelles erneutes Handshake mit korrektem Redirect.
VPN-Skalierung: Vertikal, Horizontal und „Intelligenter“ Auto-Scaling
Vertikales Wachstum: Wann passt es?
Mächtige CPU-Kerne, AES-NI, ChaCha20-Poly1305, DPU-Beschleunigung treiben VPN-Geschwindigkeit. Vertikale Upgrades schließen Bedarf schnell, allerdings mit Limits: Kosten steigen, Skaleneffekt sinkt, und Einzelausfall schadet umso mehr. Bei kleinen Installationen (bis 2–3 Gbit/s) ist vertical scaling ökonomisch sinnvoll. Doch ab da empfiehlt sich horizontale Verteilung.
Wie merkst du den Engpass? Ein Node stemmt 10–12 Gbit/s WireGuard bei 70–80 % CPU und IRQ-Metriken sind nahe der Grenze? Dann geht es an horizontale Skalierung: NUMA-optimiertes Tuning, Interrupt-Pinning, Receive-Side-Scaling, net.core.rmem/wmem erhöhen, MTU angleichen – und in die Breite gehen.
Horizontale Skalierung, Cluster und Anycast
Horizontal skalieren ist dein Freund. Neue Nodes kommen hinzu, Balancer verteilt Peers, Anycast bringt neue Nutzer zum nächstgelegenen PoP. Erfolg kommt mit minimalem Overhead beim Hinzufügen: automatisches Bootstrapping, GitOps-Config-Updates, Readiness-Prüfung, smoothing in den Pool. Ebenso einfach läuft das Entfernen via Drain.
Über Multi-Cloud hinweg finden wir Muster mit regionalem Cloud NLB, dahinter Pools von VMs mit WireGuard/OpenVPN, darüber Config-Manager und externem Monitoring, frontal topped von Anycast-IP aus mehreren Regionen. Das funktioniert glatt, solange Health Checks sauber laufen und Nutzer-ID-Stickiness stimmt.
Auto-Scaling nach den richtigen Signalen
CPU-basierter Auto-Scale ist zu grob. 2026 beobachtet man eher „effektive Sessions“, PPS/BPS, P95/99 Latenz, Anstieg von Handshake-Fehlern und Drop-Rate. Regeln sind simpel: Steigt P95 Latenz in 3 Minuten um 30 %, PPS pro Node über X – neuen Node hochfahren. Sackt Last über 15 Minuten stabil ab – Node in Drain. Vermeide „Oscillationen“ durch Min/Max-Grenzen und Cooldown-Perioden zwischen Aktionen.
Wichtig: Kostenkontrolle! Jeder Node kostet Geld. Saisonale Last (z.B. 9 bis 11 Uhr) verlangt reservierte „Heißreserven“ von 10–15 % über Durchschnitt. Du zahlst so mehr Stabilität, denn Lastspitzen werden abgefedert.
Sicherheit und Resilienz: DDoS, Zero Trust und Compliance
Schutz gegen UDP-Floods und L7-Spezifika
VPN läuft viel über UDP – ein beliebtes DDoS-Ziel. Am Perimeter filtere Frequenzen, setze Provider-Vorfilter, eBPF-Rate Limits für Handshake-Pakete und conntrack-Tuning ein. Im Load Balancer aktiviere Flood Protection und whiteliste bevorzugt nach AS oder Geographie (wenn unverzichtbar). Vergiss Cookie-Puzzles bei Handshake in kommerziellen Lösungen nicht – das senkt deine Angriffs-Kosten und erhöht die der Angreifer.
Auf Layer 7 nutze für OpenVPN/TLS und IPsec/IKEv2 streng definierte Cipher Suites, meide alte Algorithmen, setze Perfect Forward Secrecy ein, verlängere Zertifikate rechtzeitig und nutze HSMs/DPU-Beschleuniger, wo sinnvoll. Keine temporären MD5-Einschaltungen – niemals.
Zero Trust und Segmentierung
VPN ohne Segmentierung gleicht einem Schlüsselbund mit einem Schlüssel für alle Türen. 2026 ist das out. Setze policy-basiertes Routing, Device Posture Checks, kurzlebige Tokens und Identitätsbindung (IdP, MFA) ein. Segmentiere via Routen, ACLs und sogar geografisch nach PoP. Der Load Balancer muss wissen, welche Politik für wen gilt und welche Nodes welche Nutzergruppen bedienen dürfen. So erreichst du Sicherheit, Performance und Kostenkontrolle zugleich.
Compliance und Protokollierung
VPN-Logs sind in vielen Branchen rechtliche Beweismittel. Speichere Verbindungs-Metadaten, Fehlerursachen, Clients-Versionen und Kryptoparameter. Achte auf nötige Anonymisierung und halte dich an regionale Datenhaltungsvorgaben. Wenn Anycast den Nutzer in eine andere Region lenkt, prüfe, ob das erlaubt ist. Lastverteilung darf Compliance nicht gefährden.
Praxisbeispiele und Templates für OpenVPN, WireGuard und IPsec
WireGuard: Schnelles UDP mit hoher Sticky-Anforderung
WireGuard liebt Minimalismus und Tempo. Zum Lastenbalancieren empfiehlt sich L4 mit konsistentem Hash nach öffentlichem Peer-Key. Eingangs Anycast-IP am PoP, intern NLB/HAProxy/Envoy mit Ring-Hash. Health Checks: Test-Peer, Keepalive-Austausch, Handshake-Monitoring. Autoskaliere mit PPS/BPS-Metriken und aktiven Peers. Updates erfolgen über Drain-Mode und atomare Konfigurationsanwendung. So halten wir 60.000 simultane Peers mit P99 < 120 ms in drei Regionen.
Tuning: net.core.rmem_max, rmem_default, busy_poll an Interfaces, korrekte Offloads am NIC, IRQ-Pinning auf Cores. ChaCha20-Poly1305 boostet CPU-bound Szenarien. Sicherheit: Verbindungsaufnahme während Attacken limitieren, Rate Limit auf Handshakes setzen.
OpenVPN: TCP/UDP und hohe Flexibilität
OpenVPN ist der Allrounder. Für TCP simpler Load Balancer mit Least Connections, Session Resumption und Sticky über TLS-Sessions. Bei UDP Sticky anhand Client-CN oder Username, sonst wandern Verbindungen. Health Checks: Testhandshake, Tunnel-Ping, Logging von Re-Negotiation. Große Deployments trennen Control und Data Plane, sharden Nutzergruppen.
Beispiel: FinTech mit 1 Mio. MAU und Peaks bis 85.000 Sessions. Wechsel von statischem RR zu adaptivem Least Load basierend auf CPU, PPS und P95-Latenz. Einführung von Drain-Mode bei Releases. Ergebnis: 42 % weniger Reconnect-Fälle und 35 % bessere P99-Latenz ohne neue Hardware.
IPsec/IKEv2: Zuverlässig, aber etwas „schwerer“
IPsec ist ideal für Site-to-Site und Enterprise-Mobile. Lastverteilung via Anycast am Perimeter, dann L4 mit konsistentem Hash auf IKE-ID (IDi) oder EAP-Login. Wichtig: SA-Synchronisation beim Failover. Wenn keine vollständige Replikation, dann schnelles Rekey mit korrektem Redirect. Health Checks umfassen Test-SAs und ESP-Drop-Metriken. NAT-T auf UDP 4500, große MTU und Fragmentierung beachten. Leistung profitiert stark von Hardware-Offload durch SmartNIC/DPU.
Metriken, SLOs und Wirtschaftlichkeit: So erkennst du, dass alles läuft
Node- und Cluster-Level Metriken
Nicht nur CPU und RAM zählen. Kritisch sind Eingangs- und Ausgangs-PPS/BPS, aktive Sessions/Peers, Handshake-Rate, drop/queue auf Interfaces, Latenzen P50/P95/P99, Fehlerquoten bei Verschlüsselung, TCP-Retransmits und UDP-Fragmentierung. Balancer-intern trackst du Algorithmus-Verteilung, Sticky-Crossover-Anteil und Reaktionszeiten bei Health Fail. So erkennst du Anomalien frühzeitig.
Auf Cluster-Ebene ist die Lastverteilung wichtig: Variationskoeffizient zwischen Nodes sollte 0,25 nicht dauerhaft übersteigen – sonst arbeiten Algorithmen nicht oder es gibt Problemkunden. Dann helfen Client-Quoten: PPS-Spitzen限制, damit ein einzelner Nutzer nicht alle ausbremst.
SLO und Alerts ohne Panik
Formuliere klare SLOs: Anycast PoP Verfügbarkeit 99,95 % monatlich, P99-Latenz unter 150 ms regional, Reconnect-Rate unter 1,5 % pro Stunde bei 10.000 Sessions, Handshake-Fehler unter 0,4 %. Alerts bei Überschreitung über N Minuten mit Suppression bei Lastspitzen. Reports geben nicht nur rote Warnlampen, sondern auch klare Handlungsempfehlungen: Node hinzufügen, Drain starten, Routing prüfen, MTU anheben.
Kosten und Kapazitätsplanung
Geld entscheidet. Plane Kapazitäten basierend auf tatsächlichen Peaks und „schweren“ Clients. Analysiere historische Lasten: Wie viel Last kommt vom Top 1 % der Nutzer? Bei zu hoher Dominanz lohnt sich Rate-Limiting für diese Nutzergruppe. Halte am PoP 20 % Reserven, global mindestens 10 %. Auto-Scaling in Clouds mit Budget-Grenzen sichern, damit bei Metrikfehlern nicht nachts Kosten explodieren.
Fehler und Anti-Pattern: Worauf man am häufigsten ausrutscht
Lastverteilung nach Verbindungen statt Last
Klassischer Fehler: Einfach Sessions zählen und sich freuen. Resultat: Ein Node hat riesige Traffic-„Elefanten“, andere nur „Mäuschen“, aber alle gleich viele Verbindungen. Lösung: PPS/BPS basierte Least Load und Quoten für große Nutzer.
Health Check nur „Port offen“ und mehr nicht
Der Port kann offen sein, der Tunnel aber tod. Füge funktionale Checks, synthetische Transaktionen und externe Überwachung ein. Setze Hysterese und Entscheidungskaskaden ein, um bei kurzen Ausfällen nicht wild zu schalten.
Kein Drain-Mode und kein sanftes Update
Rollt man einfach zurück, brechen alle Verbindungen, SLA fällt. Nicht so! Schalte Drain, warte bis Sessions auslaufen, update dann und bring Node zurück. Ruhig, ohne Ruckler und Panik.
Schritt-für-Schritt-Plan für VPN-Lastverteilung
Schritt 1: Messen statt raten
Sammle Metriken: PPS/BPS, Peers, Handshake-Rate, Latenzen, Drop. Erstelle Zeitprofile und finde Lastspitzen. Ohne Daten ist jede Entscheidung Kaffeesatzleserei.
Schritt 2: Wähle die Architektur
Klein bis mittel: L4-Load Balancer vor Pool, Sticky nach Nutzer-ID, Health Checks mit Test-Peer. Global: Anycast+BGP am Perimeter, darin NLB/HAProxy/Envoy, Auto-Scaling und externe Checks aus verschiedenen ASN.
Schritt 3: Konfiguriere Algorithmen und Sticky
Starte mit Least Load und konsistentem Hash nach stabilem Schlüssel (CN, Public Key, IDi). Prüfe Verteilungsfluktuationen bei Clusteränderungen. Aktiviere Quoten für große Nutzer und humane Migrationslogik bei Drain.
Schritt 4: Implementiere Health Checks und Entscheidungs-Kaskaden
Setze schnelle L4-Checks, langsame funktionale Tests und externe synthetische Checks auf. Definiere Schwellen, Beobachtungsfenster und Rückkehrregelungen. Dokumentiere alles – du wirst dir bei Vorfällen danken.
Schritt 5: Auto-Scaling & Wirtschaftlichkeit
Kopple Auto-Scaling an Qualitätsmetriken (P95, Drop) und Last (PPS/BPS). Definiere Minimum und Maximum Nodes, Budgets und Cooldown-Phasen. Teste am Staging Lastspitzen und UDP-Attacken.
Schritt 6: Sicherheit und Compliance
Prüfe Kryptopolitik, Log-Verwaltung und Segmentierung. Schalte Rate Limits für Handshakes ein, setze Filter am Perimeter, kontrolliere MTU. Denke bei Bedarf über SmartNIC/DPU nach – aber nur wenn preislich sinnvoll.
Praxisfälle: Was funktioniert und was nicht
Fall 1: FinTech und Abendspitzen
Kunde mit Abendspitzen: Mobile Analytics via VPN, bis zu 85.000 simultane Sessions. Wechsel von Weighted RR zu Least Load, Sticky über CN, Drain-Mode aktiviert, Health Checks dreistufig umgesetzt. Ergebnis: 35 % weniger P99-Latenz im Peak, 42 % weniger Reconnects, Einsparung von 2 Nodes durch bessere Verteilung.
Fall 2: Anycast und Multi-Cloud
Globaler SaaS mit 6 PoPs. Anycast bringt Nutzer zum nächstgelegenen PoP. Binnen PoP NLB mit Ring-Hash auf WireGuard Public Key. Externes Monitoring ermöglicht das Abschalten degradierten Regions in 20–30 Sekunden via BGP-Updates und schnellen Health Checks. Verfügbarkeit an 99,97 % in Quartal.
Fall 3: DDoS und Handshake-Überlast
UDP-Flood gegen WireGuard-Ports verursacht massive Handshake-Welle. Eingesetzte Maßnahmen: eBPF-Rate Limits, Cookie-Checks beim Handshake, Provider-Filter. Temporäre Reduzierung der Handshake-Frequenz durch Clients. P95 kehrte in 7 Minuten zum Normalwert zurück, Business merkte nur leichte Eintrübungen für knapp 5 Minuten.
Checkliste vor dem Go-Live: Haben wir alles im Griff?
Technisch
- Lastverteilungsalgorithmus: Least Load + konsistenter Hash
- Sticky nach stabilem Nutzer-ID
- Kaskadierte Health Checks: schnell, funktional, extern
- Drain Mode und sanfte Updates
- Auto-Scaling mit P95/PPS/BPS und Budgetgrenzen
- Logs, Alerts, SLOs und Post-Mortems
Netzwerk
- Anycast+BGP für globale PoPs
- Angemessene MTU und Fragmentierung
- ECMP-Symmetrie und Routen-Diagnose
- Filter am Perimeter, Rate Limits für Handshake
Organisation
- Dokumentation und Runbooks
- Incident-Tests und Trainingslastspitzen
- Regionale Compliance-Abstimmung
- Rollback-Plan in 5 Minuten
FAQ: Häufige Fragen zur VPN-Lastverteilung
Welchen Lastverteilungsalgorithmus sollte ich zuerst nutzen?
Starte mit Least Load und konsistentem Hash nach stabilem Nutzer-Schlüssel. Das sorgt für gute Gleichmäßigkeit und Session-Stabilität ohne „Springer“ bei Node-Hinzufügung. Round Robin ist nur für Testumgebungen geeignet.
Brauche ich Anycast, wenn mein Land klein ist?
Hast du mehrere Regionen innerhalb eines Landes mit räumlich verteilten Nutzern, hilft Anycast die Latenz zu reduzieren und PoP-Ausfälle zu kompensieren. Für einzelne Städte und einen PoP ist der Gewinn gering – konzentriere dich lieber auf robuste L4-Load Balancer und Health Checks.
Wie setze ich Sticky für WireGuard um?
Nutze konsistentes Hashing des öffentlichen Peer-Schlüssels. Das ist stabiler als Source IP, vor allem bei CGNAT. Auf Balancer oder Controller solltest du das Mapping peer → Node speichern, damit neue Handshakes nicht auf andere Server wandern.
Was sollte ich in Health Checks neben Ports prüfen?
Handshakes, Austausch von Testpaketen über Tunnel, Latenzen P95/P99, Paketverluste, Kryptografiefehler, Warteschlangenlänge. Externe Checks von verschiedenen ASN aus sind Pflicht, um Provider-Ausfälle zu erfassen.
Wie aktualisiere ich ohne Downtime?
Schalte Drain Mode ein, warte das natürliche Auslaufen der Sessions ab, nutze Graceful oder ganz nahtloses Restart. Bei WireGuard atomic Config Apply, bei OpenVPN Session Resumption, bei IPsec schnelle Rekey-operationen und korrektes Redirect.
Lohnen sich Investitionen in DPU/SmartNIC?
Bei mehreren zehn Gbit/s pro Node und relevanter Latenz unter Last ja. Für kleine Installationen sind eine saubere L4-Lastverteilung, Auto-Scaling und guter Netzwerkstack sinnvoller.
Welche SLOs sollte man zu Beginn setzen?
Verfügbarkeit 99,9–99,95 % pro Monat für PoP, P99-Latenz <150 ms für regionale Nutzer, Reconnect-Rate <2 % pro Stunde bei 10.000 Sessions, Handshake-Fehler <0,5 %. Später kannst du die Ziele bei steigender Reife verschärfen.
