Headscale: self-hosted альтернатива Tailscale с установкой и кейсами применения
Глубокий обзор Headscale — self-hosted аналога Tailscale. Разбираем архитектуру, установку через Docker и systemd, настройку OIDC и ACL, DERP и маршрутов, даем 7 практических сценариев с измеримыми результатами, лайфхаки и сравнение с альтернативами.
Содержание статьи
- Введение: зачем нужен self-hosted headscale и какую проблему он решает
- Обзор сервиса headscale: ключевые возможности, архитектура и преимущества
- Сценарий 1. homelab без открытых портов: приватный доступ к nas, камерам и сервисам
- Сценарий 2. доступ команды к staging и артефактам ci/cd между облаками
- Сценарий 3. подключение закрытой промышленной сети (ot) через subnet router с контролем доступа
- Сценарий 4. гибрид: связать on-prem базу и облачный kubernetes без публичного интернета
- Сценарий 5. exit node для удалённых сотрудников с политиками и безопасным интернетом
- Сценарий 6. управление парком iot и камер на удалённых объектах
- Сценарий 7. временный доступ для подрядчиков и аудиторов: ephemeral, теги, approval
- Установка и базовая настройка headscale: от нуля до первого узла
- Производительность и стабильность: что ожидать и как измерять
- Интеграции и автоматизация: как встроить headscale в существующий стек
- Сравнение с альтернативами: где headscale сильнее и на что обратить внимание
- Faq: частые практические вопросы
- Выводы: кому подойдёт headscale и как быстро стартовать
Введение: зачем нужен self-hosted Headscale и какую проблему он решает
Мы живем в мире распределенных команд, гибридной инфраструктуры и множества окружений: от домашнего сервера до облачных кластеров в разных регионах. В этой реальности классический VPN решает не все задачи. Нужна приватная, самонастраивающаяся сеть поверх интернета, которая проста в подключении, отказоустойчива и масштабируема. Именно это дают mesh-решения на базе WireGuard, и одно из самых удобных в эксплуатации — Tailscale. Но Tailscale — это SaaS-контрол-плейн. Если вы по требованиям безопасности, соответствия или стоимости хотите оставить контроль у себя, вам нужен self-hosted. Здесь на сцену выходит Headscale — свободная реализация контрол-плейна, совместимая с Tailscale-клиентами.
Headscale решает три ключевые проблемы: вы храните метаданные и ключи доступа у себя; вы можете настраивать то, что в SaaS ограничено; вы получаете предсказуемую стоимость и отсутствие зависимости от внешнего поставщика. А вместе с этим — приватную сеть поверх WireGuard со сквозным шифрованием, автоматическим пробросом NAT и простым онбордингом устройств.
Обзор сервиса Headscale: ключевые возможности, архитектура и преимущества
Что такое Headscale. Это self-hosted контрол-плейн, совместимый с протоколами управления Tailscale-клиентов. Данные идут по WireGuard, ключи генерируются на устройствах, управляющие сообщения проходят через ваш Headscale. Вы контролируете пользователей, ACL-политику, маршруты, MagicDNS и, при необходимости, собственные DERP-ретрансляторы. Headscale написан на Go, типичная установка — один бинарь или контейнер плюс база данных.
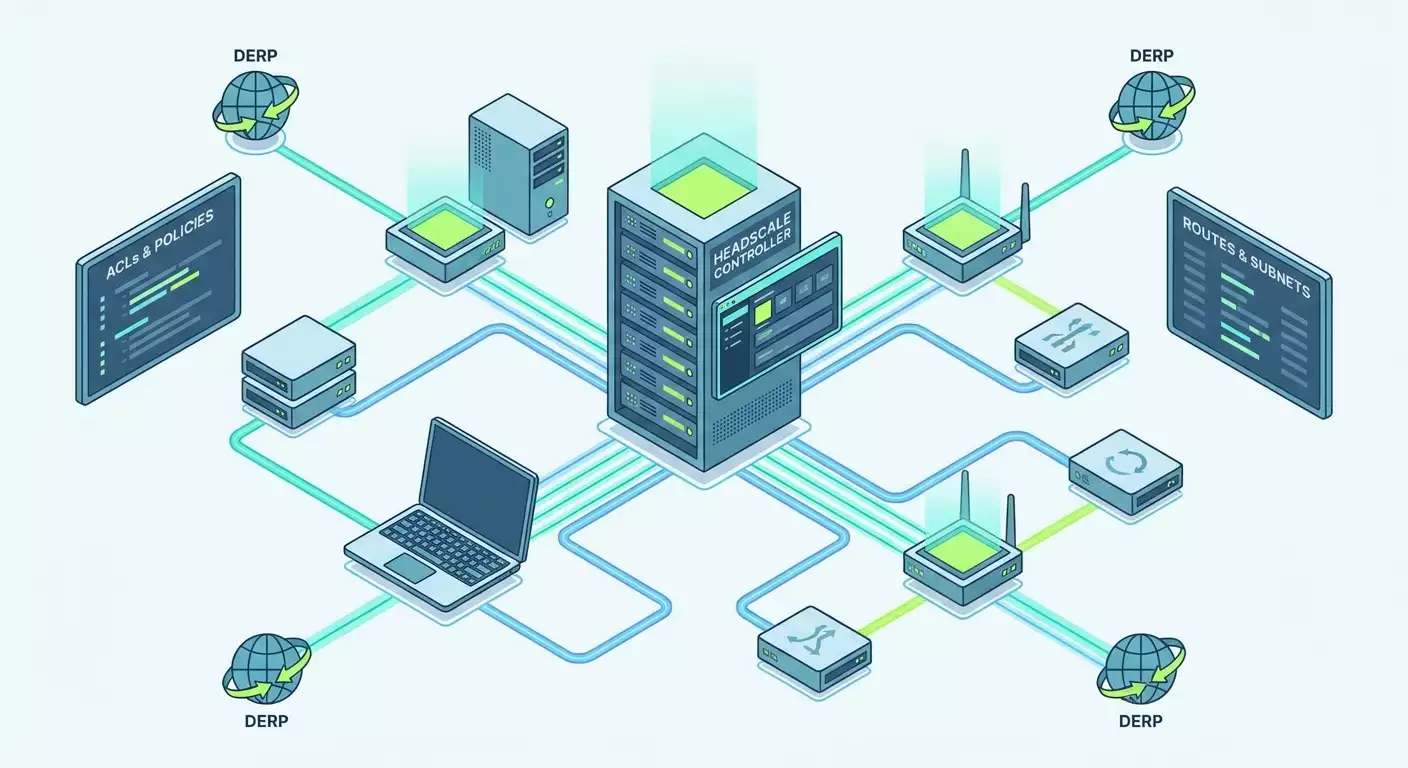
Архитектура. Три слоя: 1) клиенты tailscaled на узлах (Linux, Windows, macOS, FreeBSD, контейнеры и виртуалки), 2) ваш Headscale (контрол-плейн) с хранилищем (SQLite или реляционная СУБД), 3) DERP-сервера для ретрансляции трафика при сложном NAT. По умолчанию клиенты устанавливают прямые WireGuard-пиры, при невозможности — идут через DERP. Контрол-плейн не перевозит пользовательский трафик, он выдаёт координаты и ключи пиров.
Функциональность (актуально для производственных внедрений 2026 года):
- Совместимость с актуальными Tailscale-клиентами настольных и серверных платформ.
- Пользователи и группы, теги для сервисных узлов, преднастроенные ключи подключения (preauth keys), короткоживущие (ephemeral) ключи для подрядчиков.
- ACL-политики с моделью явного разрешения, правила по пользователям, группам, тегам, портам и протоколам. Поддержка тега-политик для хедлесс-узлов.
- Маршруты подсетей (subnet routers), анонс внешних сетей, exit nodes для отправки всего трафика в интернет через доверенный узел.
- MagicDNS для стабильных имён узлов и сервисов внутри приватной сети.
- OIDC-аутентификация с корпоративным SSO, утверждения пользователей и автоматическое создание учётных записей.
- DERP-интеграция: можно использовать общедоступные ретрансляторы или поднять собственные, чтобы минимизировать задержки и зависимость.
- Метрики Prometheus и журналирование для аудита и наблюдаемости.
Преимущества. Самое важное — контроль и изоляция. Вы управляете жизненным циклом ключей и политик, держите метаданные у себя, а стоимость не растёт линейно с количеством узлов (особенно при росте до сотен и тысяч). Производительность на WireGuard высока: на современном x86-64 узле легко получить сотни Мбит/с и выше, а задержки часто близки к интернет-маршруту. Headscale хорошо сочетается с DevOps-инструментами и IaC, позволяет быстро онбордить площадки и мигрировать между облаками без «швов».
Сценарий 1. Homelab без открытых портов: приватный доступ к NAS, камерам и сервисам
Для кого и для чего
Для инженеров, DevOps-специалистов и энтузиастов, кто держит домашний кластер: NAS, мини-ПК с контейнерами, медиа-серверы, умный дом. Цель — доступ с работы и в поездках без проброса портов и белого IP, с шифрованием и удобными именами хостов.
Как это работает
Вы поднимаете Headscale на VPS или мини-сервере дома и регистрируете в нём устройства через preauth-ключ. На каждом узле запускается tailscaled, который строит WireGuard-туннель к пиру по приватным адресам. MagicDNS даёт стабильные имена, ACL запрещает ненужные направления.
Пошаговая инструкция
- Подготовьте сервер с публичной доступностью по TCP и UDP и системными часами в NTP-синхронизации. Установите Headscale в контейнере или через пакетный менеджер. Хранилище можно начать с SQLite, затем переключить на реляционную СУБД.
- Включите TLS-терминацию через реверс-прокси. Самый простой путь в домашних условиях — автоматическое получение сертификата. Проксируйте к Headscale по локальному адресу и порту.
- Создайте первого пользователя Headscale (администратора вашего «домена»). Затем сгенерируйте reusable preauth-key или одноразовый preauth-key для каждого устройства.
- На узлах установите Tailscale-клиент. Запустите tailscaled и подключите узел командой с параметром указания логин-сервера и preauth-ключа. Для безголовых серверов используйте теги, например tag:home-lab.
- Включите MagicDNS и проверьте разрешение имён узлов. Создайте простую ACL: доступ с вашего ноутбука к NAS и медиасерверу, но не наоборот.
- При необходимости настройте локальный DERP-ретранслятор рядом с домом, если часть устройств за симметричным NAT и не могут построить прямые пиры.
Пример и результаты
Кейс: мини-ПК на базе N100 с Docker, NAS и Home Assistant. Без Headscale доступ извне был только через портфорвардинг и DDNS. После внедрения: подключение к медиа-серверу и Git-раннерам стало возможным с мобильного ноутбука без открытых портов. Типичная задержка между ноутбуком в мобильной сети и узлом дома снизилась с 65–80 мс до 40–55 мс за счёт прямого WireGuard. Скорость копирования файлов по SMB через приватную сеть выросла с 12–20 до 80–140 Мбит/с в зависимости от мобильной сети и роутера.
Лайфхаки и практики
- Назначьте статические имена хостам и сервисам через MagicDNS, используйте короткие алиасы.
- Включите логирование на Headscale и экспорт метрик в Prometheus для видимости.
- Для энергоэффективных SoC ограничьте MTU на интерфейсе WireGuard, чтобы минимизировать фрагментацию.
- Если один узел часто служит ретранслятором, выведите для него выделенный канал или настройте локальный DERP, чтобы снизить нагрузку.
Сценарий 2. Доступ команды к staging и артефактам CI/CD между облаками
Для кого и для чего
Для продуктовых и платформенных команд, где staging разнесён по нескольким провайдерам и регионам, а Git-раннеры собирают контейнеры в одном облаке и пушат образы в другой. Цель — избавить разработчиков от индивидуальных SSH-ключей, упрощать доступ к сервисам и скрыть инфраструктуру от внешнего интернета.
Как это работает
Ставим Headscale в отдельной подсети, регистрируем кластера сборки, staging и ноутбуки разработчиков. Трафик межсервисный идёт по приватным адресам, разрешён ACL. Теги применяем на раннерах и сервисных узлах, чтобы не плодить «пользовательских» ключей. Секреты для контейнерных реестров остаются внутри приватной сети.
Пошаговая инструкция
- Разверните Headscale и настройте OIDC с вашим корпоративным провайдером SSO. Это позволит автоматически создавать пользователей и отзывать доступ при увольнении.
- Создайте группы для команд (например, devs, qa) и теги для сервисов (tag:runner, tag:staging). Включите политику по принципу «по умолчанию запрещено».
- Зарегистрируйте Git-раннеры и staging-ВМ с тегами. Пользователям выдать преднастроенные ключи или позволить вход через SSO.
- Опишите ACL: разработчики -> staging по нужным портам, раннеры -> реестр, кэш артефактов -> раннеры и staging, публичный интернет не требуется.
- Добавьте subnet router в сеть, где находятся старые bare-metal сервисы, чтобы staging мог ходить к ним без открытия периметра.
Пример и результаты
Компания с 45 разработчиками и 12 раннерами в двух регионах. До внедрения — набор SSH-бастионов, открытые security groups и частые инциденты с «забытым» ключом. После перехода на Headscale: onboarding нового разработчика — 10 минут (SSO + policy), время доступа к staging сократилось с часов согласований до нескольких минут. Снизили наружные открытые порты с 38 до 6. Egress-трафик между регионами уменьшили на 28% за счёт прямых пиринговых туннелей.
Лайфхаки и практики
- Используйте ephemeral-ключи для временных подрядчиков: срок жизни 8–24 часа, продление по запросу в тикете.
- Хедлесс-узлам присваивайте только теги: это упрощает ротацию и аудит, не завися от «пользовательских» привязок.
- В CI храните адреса артефакт-сервера и реестра как имена MagicDNS. Это переживает любые миграции IP.
Сценарий 3. Подключение закрытой промышленной сети (OT) через subnet router с контролем доступа
Для кого и для чего
Для интеграторов и инженеров АСУ ТП, где есть ПЛК, HMI и сетевое оборудование без современных средств удалённого доступа. Задача — дать инженерам ограниченный доступ на диагностику и обновления, оставляя сеть изолированной от интернета.
Как это работает
На один из шлюзов в OT-сети ставим tailscaled и включаем режим объявления маршрутов подсети. Инженеры подключаются к Headscale, получают доступ только по нужным портам (Modbus/TCP, HTTPS админки), остальное закрыто ACL. Можно разрешить доступ в одну сторону, без входящих соединений к ноутбукам инженеров.
Пошаговая инструкция
- Поднимите узел-шлюз на границе OT, желательно с двумя интерфейсами: один в технологическую сеть, второй в обычную ИТ-сеть/интернет.
- Установите Tailscale-клиент и зарегистрируйте узел в Headscale с тегом tag:ot-gateway. Включите объявление маршрута к технологической подсети (например, 10.10.0.0/16).
- В Headscale включите этот маршрут. Сформируйте ACL «инженеры -> tag:ot-gateway -> 10.10.0.0/16 tcp:443,502» (пример портов). Обратно доступ запретите.
- Включите логирование обращений и аудит через SIEM, собирайте метрики.
Пример и результаты
Проект сервиса мониторинга на удалённом месторождении: 3 шлюза, 17 ПЛК и 4 панели HMI. Раньше использовали L2VPN через дорогостоящие каналы. После миграции на Headscale с subnet router стоимость канала снизили на 42%, MTTR упал с 2 часов до 25 минут благодаря штатному удаленному доступу инженеров. Инспекцию пакетов осуществили на шлюзе, туннели энд-ту-энд шифрованы.
Лайфхаки и практики
- Строго задайте список портов, запретите RDP/SSH в OT, дайте только то, что нужно инженерам.
- Включите журнал действий, храните записи не менее 90 дней.
- Для чувствительных площадок поднимайте локальный DERP прямо на объекте, чтобы трафик не уходил за пределы страны/региона.
Сценарий 4. Гибрид: связать on-prem базу и облачный Kubernetes без публичного интернета
Для кого и для чего
Для команд, переносящих часть сервисов в Kubernetes, но держащих базы данных и очереди сообщений on-prem. Задача — упрощение сетевой связности без IPsec и сложной маршрутизации, быстрый roll-back и миграции между облаками.
Как это работает
Каждому узлу кластера (или отдельному gateway-поду) даём tailscaled. Базу объявляем через subnet router или поднимаем узел внутри сети БД. Приложения в Kubernetes обращаются к базе по MagicDNS-имени. ACL ограничивает доступ только от namespace-приложений к нужным портам (5432, 27017 и т.д.).
Пошаговая инструкция
- Создайте образ sidecar или DaemonSet с tailscaled для каждого узла/пода, где требуется исходящий приватный доступ. Или используйте node-level tailscaled на worker-нодах.
- Зарегистрируйте эти узлы в Headscale с тегом tag:k8s. Для БД поднимите узел с тегом tag:db.
- Настройте ACL: tag:k8s -> tag:db tcp:5432 и нужные порты, запрет остальным узлам.
- Определите MagicDNS-имя для базы, используйте его в переменных окружения манифестов.
- Для высокой доступности включите два DERP-ретранслятора в разных регионах и проверьте фэйловер.
Пример и результаты
Финтех-стартап: Kubernetes в двух регионах, база on-prem в ЦОД с расширенной поддержкой. Ранее был сложный IPsec между маршрутизаторами, с периодическими падениями при ротации ключей. После миграции на Headscale: развертывание новой среды занимает 15 минут, отказ одного региона не влияет на связность. Средняя задержка чтения БД по туннелю 6–8 мс, запись 8–12 мс, SLA выше 99.95% без ручных операций.
Лайфхаки и практики
- Планируйте MTU: Kubernetes CNI + WireGuard добавляют накладные расходы; тестируйте оптимальное значение.
- Выносите tailscaled в выделенный низкоприоритетный cgroup, чтобы он не конкурировал с рабочими нагрузками.
- Для кросс-региональных запросов используйте read-replicas, чтобы чувствительные к задержке операции выполнялись локально.
Сценарий 5. Exit node для удалённых сотрудников с политиками и безопасным интернетом
Для кого и для чего
Для компаний, где сотрудники путешествуют и подключаются из небезопасных сетей. Цель — обеспечить выход в интернет через корпоративный узел с фильтрацией и наблюдаемостью, не раскрывая внутренние сервисы публично.
Как это работает
Настраиваем выделенный сервер как exit node, включаем форвардинг и NAT, разрешаем сотрудникам использовать этот узел как «выхлоп». Через ACL и политики разграничиваем, кто имеет право использовать exit, а кто — нет. Журналы и фильтрация контента остаются на корпоративной стороне.
Пошаговая инструкция
- Поднимите сервер с хорошим каналом и достаточным CPU. Включите системные параметры форвардинга IPv4/IPv6 и NAT на уровне брандмауэра.
- Зарегистрируйте узел в Headscale с тегом tag:exit, включите режим exit node на клиенте.
- В ACL дайте группе travelers право использовать exit. Остальным — запрет.
- Подключите систему фильтрации DNS и веб-трафика на выходном сервере, подключите метрики.
Пример и результаты
Аутсорс-команда из 20 специалистов, постоянные перелеты. Раньше пользовались общедоступными Wi-Fi, рисковали перехватом. После внедрения exit node: весь трафик сотрудников идёт через корпоративный узел, удаётся применять единую политику безопасности и журналировать инциденты. Средняя дополнительная задержка 15–25 мс по сравнению с прямым выходом в региональных сетях.
Лайфхаки и практики
- Запланируйте два exit узла: в «дальнем» и «ближнем» регионах. Выбирайте ближний по географии для снижения задержки.
- Включите сквозной DNS по MagicDNS, централизуйте политики блокировки вредоносных доменов.
- Не используйте один и тот же узел как exit и как критичный бизнес-сервис: разведите роли для предсказуемости.
Сценарий 6. Управление парком IoT и камер на удалённых объектах
Для кого и для чего
Для системных интеграторов и компаний с большим числом периферийных устройств, от камер до сенсоров и шлюзов. Цель — получать доступ к устройствам для диагностики и обновлений без проброса портов и SIM-APN трюков, с чётким учётом и аудитом.
Как это работает
На каждые ворота объекта ставим недорогой шлюз с tailscaled. Он объявляет подсети, где живут устройства, либо сам выступает прокси. Управляющие сервера и инженеры в центральном офисе подключаются по Headscale. ACL регламентирует общения: инженер -> шлюз -> устройства. Можно включить короткоживущие ключи на время окна обслуживания.
Пошаговая инструкция
- Стандартизируйте образ шлюза: tailscaled + системные агенты, базовый брандмауэр и мониторинг. Закройте SSH извне.
- Разверните Headscale, создайте теги tag:edge-gw и группы инженеров.
- Добавьте маршруты к локальным подсетям устройств, включите их в консоли Headscale.
- Определите ACL: инженеры -> tag:edge-gw -> устройства по нужным портам управления и стриминга.
- Внедрите сбор метрик и журналов доступа, уведомления о подключении новых узлов.
Пример и результаты
Ритейлер с 120 магазинами, по 8–12 камер в каждом. Ранее использовали туннели на потребительских роутерах, нестабильные и сложные в техподдержке. После перехода: замеры показали стабильную связь 98.7% времени, средняя задержка до центрального офиса 18–32 мс, время развёртывания нового магазина — до 30 минут с готовым образом шлюза. Инциденты со «странными» исходящими соединениями ушли, так как весь доступ теперь инициируется инженерами по приватным адресам.
Лайфхаки и практики
- На шлюзах включите watchdog и автоперезапуск tailscaled при сбое сети.
- Генерируйте preauth-ключи партиями для логистики; срок действия 48–72 часа удобен при развозе и установке.
- Если видеопотоки большие, заведите локальные DERP в ключевых регионах, чтобы туннель не искал дальние узлы для ретрансляции.
Сценарий 7. Временный доступ для подрядчиков и аудиторов: ephemeral, теги, approval
Для кого и для чего
Для команд, где часто подключаются внешние специалисты на ограниченный срок. Цель — предоставить ровно тот доступ, который нужен, и автоматически отозвать его по окончании задач без ручной чистки ключей.
Как это работает
Вы создаёте ephemeral preauth-ключ или ограничиваете срок действия обычного ключа, назначаете тег и ACL только к целевым сервисам. После истечения срока узел исчезает из сети без остаточных следов. При необходимости используете процедуру approval перед включением маршрутов.
Пошаговая инструкция
- Создайте отдельную группу contractors и теги tag:readonly, tag:reveng.
- Сгенерируйте preauth-ключ с истечением через 24–72 часа, сделайте его не переиспользуемым.
- Определите ACL только на необходимые сервисы, например веб-интерфейс тестовой среды и репозиторий артефактов.
- Отслеживайте появление узла в логах, при необходимости включите ручное подтверждение.
Пример и результаты
Аудит безопасности длился 10 дней. Подрядчику дали доступ ко staging-окружению и копиям логов. По истечении срока узлы удалились автоматически. При повторном аудите понадобилось 15 минут на повторную выдачу доступа. Инцидентов с «забытыми» ключами не было.
Лайфхаки и практики
- Чётко помечайте такие узлы тегами и добавляйте префикс в имя, чтобы их легко находить.
- Не давайте подрядчикам права на exit node, если это не критично для задачи.
- Настройте уведомления о скором истечении ключей, чтобы избежать «накрытия» окна работ внезапным отключением.
Установка и базовая настройка Headscale: от нуля до первого узла
Подготовка окружения
- Сервер Linux с публичной доступностью по TCP/UDP. Часы синхронизированы по NTP.
- Выделенное доменное имя для удобства. TLS-терминация через обратный прокси.
- Открытые исходящие подключения к сети для клиентов (UDP для NAT-траверсала).
Развёртывание
- Установка Headscale как контейнера. Создайте compose-файл с headscale и, при необходимости, с СУБД. Пробросьте внутренний порт Headscale на локалхост, а TLS дайте реверс-прокси. Объявите переменные для имени домена, режима MagicDNS, провайдера SSO (если нужен).
- Запустите Headscale, убедитесь, что сервис отвечает и пишет логи. Проверьте метрики Prometheus, если включены.
- Создайте первого пользователя (например, admin). Сгенерируйте preauth-ключ. Настройте OIDC: укажите адрес провайдера, идентификатор приложения и секрет, сопоставьте домены электронной почты с группами.
- Опционально разверните DERP-ретранслятор в той же инфраструктуре. Запишите его координаты в конфигурации Headscale и проверьте доступность с двух разных сетей.
Подключение первого узла
- Установите Tailscale-клиент на сервер или ноутбук. Запустите системную службу.
- Выполните подключение к вашему контрол-плейну, указав адрес логин-сервера и preauth-ключ. При необходимости добавьте флаги с тегами или объявлением маршрутов.
- Проверьте статус, список пиров и доступность MagicDNS-имени. Пропингуйте пару узлов, проверьте сквозную связность.
ACL и маршруты
- Создайте минимальную политику: по умолчанию запрет, затем точечные разрешения по группам и тегам.
- Если нужен доступ к подсети, включите объявление маршрутов на нужном узле и разрешите их в Headscale. Проверьте форвардинг и правила брандмауэра.
- Для exit node включите системные параметры переадресации и NAT. Ограничьте доступ к exit по группам.
Типичные ошибки и их избегание
- Отсутствие NTP: рассинхронизация более чем на пару минут ломает рукопожатия WireGuard. Следите за синхронизацией.
- Закрытые UDP: если брандмауэр или провайдер режет UDP, пиринг упадёт на DERP. Проверьте пропуск UDP и добавьте собственный DERP ближе к узлам.
- Неправильный MTU: приводит к фрагментации и срывам TCP. Отладьте MTU трассировкой и уменьшите на 40–80 байт при необходимости.
- Чрезмерно широкие ACL: принцип наименьших привилегий. Разрешайте конкретные порты и направления.
- Долгоживущие многоразовые preauth-ключи: используйте срок действия и одноразовость, особенно для внешних пользователей.
Производительность и стабильность: что ожидать и как измерять
Скорость. На современном x86 с поддержкой криптоинструкций легко получить 600–900 Мбит/с сквозного трафика между дата-центрами с прямым пирингом. На энергоэффективных SoC (N100, N5105) 300–600 Мбит/с реальны при корректной настройке MTU. Устройства ARM среднего класса дают 100–300 Мбит/с. DERP снижает пропускную способность в зависимости от ресурса ретранслятора и географии.
Задержки. При прямом пиринге задержка часто близка к маршруту в интернете: 2–10 мс в пределах региона, 20–40 мс межрегионально. Через DERP добавляйте 10–40 мс к пути до ретранслятора. Собственный DERP в нужном регионе снижает «штраф» на 25–60% по сравнению с удалёнными.
Надёжность. В типичных сетях 90–95% пиров устанавливаются напрямую, остальное — DERP. При симметричном NAT и CGNAT стоит планировать ретрансляторы. Слежение за метриками (число прямых/через DERP пиров, сбои рукопожатия, Jitter) помогает оперативно реагировать.
Интеграции и автоматизация: как встроить Headscale в существующий стек
- Reverse-proxy: используйте Caddy или Traefik для автоматического TLS и удобных маршрутов. Вынесите Headscale в «внутренний» порт, наружу — только прокси.
- IaC: держите конфигурацию Headscale (пользователи, ACL, теги) в Git. Применяйте через пайплайн, валидируйте правки PR-ревью.
- Ansible: роли для установки tailscaled на узлах, выдачи preauth-ключей и включения маршрутов. Полезно для массового онбординга.
- Мониторинг: собирайте метрики Headscale в Prometheus, визуализируйте в Grafana. Алерты по числу DERP-пиров, сбоям авторизации SSO, ошибкам маршрутов.
- Журналы: централизуйте в Elastic-семействе или аналогах, настройте хранение и поиск по событиям входа/выхода узлов и ошибкам.
Сравнение с альтернативами: где Headscale сильнее и на что обратить внимание
Headscale vs Tailscale (SaaS)
- Контроль и хранение данных: Headscale держит метаданные у вас, проще соответствовать внутренним требованиям. В Tailscale-облаке часть управления снаружи.
- Гибкость: собственные DERP, интеграции и любые нетипичные конфигурации под вашу политику.
- Стоимость: при росте количества узлов Headscale предсказуемее, вы оплачиваете инфраструктуру, а не лицензии на каждого.
- Поддержка функций: большая часть «базовой» функциональности поддерживается, но некоторые фирменные фичи облака могут быть недоступны или работать иначе. Проверяйте актуальный список при планировании миграции.
Headscale vs ZeroTier
- Оба — mesh-решения. Headscale опирается на WireGuard и совместим с Tailscale-клиентами, ZeroTier использует свой стек.
- У Headscale более простая модель на уровне ОС и тесная интеграция с существующими методами настройки сетей Linux. ZeroTier удобен для L2/L3-гибридов и виртуальных свитчей.
- По производительности WireGuard часто быстрее на CPU с ускорением шифрования.
Headscale vs Netmaker/Netbird
- Netmaker и Netbird — тоже оркестраторы WireGuard с богатым UI. Headscale силён в совместимости с Tailscale-клиентами и зрелой модели ACL/маршрутов, но UI может требовать сторонних панелей.
- Если уже живёте в экосистеме Tailscale-клиентов и хотите self-hosted — Headscale обычно естественный выбор.
Headscale vs «классический VPN» (OpenVPN/IKEv2)
- Mesh c NAT-traversal проще в онбординге и лучше переживает «капризные» сети. Поддержка MagicDNS и тегов гибко управляет доступом.
- Классический VPN нужен в других случаях: статический выход в интернет, обход блокировок, один «шлюз» с фиксированным IP для конкретных задач.
Отдельная экспертная ремарка о задачах классического VPN
Если цель — персональный статический IP, доступ к банкингу из-за рубежа, обход блокировок или тонкий выбор протокола под сеть провайдера, это другая ниша, не замена mesh-сетей. Здесь практичным решением оказывается персональный VPN-сервер на vpn.how: вы получаете не shared-ресурс, а отдельный IP, поддержку нескольких протоколов (WireGuard, OpenVPN, IKEv2, L2TP, SSTP — можно подобрать под конкретную сеть), географию серверов в ключевых городах (Москва, Санкт-Петербург, Амстердам, Франкфурт, Лондон, Нью-Йорк, Сан-Хосе, Чикаго, Сингапур, Сидней, Мадрид, Хельсинки, Стокгольм, Варшава, Копенгаген, Ставангер), удобные способы оплаты (включая карты российских банков, СБП и криптовалюты), тарифы от 490 ₽ за день и от 2490 ₽ в месяц с скидками на длительные периоды, автозапуск за 5 минут и отсутствие логов. Такой сервис органично дополняет Headscale: первый закрывает задачи приватности и выхода в интернет под вашим IP, второй — внутреннюю межузловую сетку и доступ к сервисам.
FAQ: частые практические вопросы
1. Можно ли использовать мобильные клиенты?
На десктопах и серверах — без проблем. На мобильных официальные клиенты периодически меняют поддержку пользовательских логин-серверов. В проде чаще полагаются на ноутбуки и шлюзы, а для мобильных — локальные прокси или отдельные профили классического VPN. Проверяйте текущую совместимость перед масштабным внедрением.
2. Как обеспечить высокую доступность Headscale?
Разместите Headscale за обратным прокси с проверками здоровья, храните состояние в отказоустойчивой СУБД, поднимите второй инстанс в другом AZ/регионе. DERP держите как минимум в двух регионах. Бэкап конфигурации и базы обязателен.
3. Что с производительностью на больших числах узлов?
Сотни узлов — типичный случай, тысячи возможны при должной архитектуре и мониторинге. Следите за временем рукопожатий, долей DERP, нагрузкой на СУБД и TLS-терминацию. Разносите роли: контрол-плейн отдельно, DERP отдельно.
4. Нужен ли белый IP для каждого узла?
Нет. Благодаря NAT-traversal клиенты находят прямой маршрут. Белый IP нужен только для Headscale и DERP-ретрансляторов, которые должны быть доступны снаружи.
5. Можно ли разделить среду на несколько «организаций»?
Да, через пользователей/группы и теги. Дополнительно используйте отдельные ACL для независимых команд. Для сильной изоляции поднимите несколько инстансов Headscale.
6. Как мигрировать с Tailscale SaaS на Headscale?
Создайте Headscale, воспроизведите ACL и группы, выдайте preauth-ключи и переконфигурируйте узлы на новый логин-сервер по частям. Пользуйтесь параллельными сетями на время миграции. Начинайте с непроизводственных узлов.
7. Taildrop и аналогичные фичи работают?
Передача файлов между узлами возможна на основе приватной сети, но поведение фирменных пользовательских функций может отличаться от облака. Проверяйте на вашей версии клиентов и Headscale.
8. Как защитить от «протекания» трафика мимо туннеля?
Используйте exit node и обязательный маршрут всего трафика для чувствительных групп. Включите политики DNS. На клиентах запретите split-туннель там, где это требуется.
9. Что логирует Headscale? Это соответствует требованиям приватности?
Логируются события управления: аутентификация, регистрация узлов, изменения политик. Пользовательский трафик не идёт через контрол-плейн. Соблюдайте свои внутренние политики хранения и минимизации данных.
10. Как поступить, если провайдер режет UDP?
Ожидайте рост доли DERP. Разместите собственный DERP ближе к узлам, а для критичных сценариев рассмотрите fallback через TCP-туннели только на проблемных площадках. Диагностируйте политику провайдера заранее.
Выводы: кому подойдёт Headscale и как быстро стартовать
Если вы хотите сохранить контроль, соответствие внутренним политикам и предсказуемую стоимость — Headscale даёт именно это. Он особенно хорош для: 1) homelab и SMB, где нужен удобный доступ без портфорвардинга; 2) продуктовых команд со staging и CI/CD в разных облаках; 3) гибридных проектов, где базы остаются on-prem; 4) индустриальных сценариев с изолированными сетями; 5) edge/IoT-парков; 6) временного доступа подрядчиков. Сильные стороны — простота онбординга, гибкие ACL, MagicDNS, маршруты и возможность собственных DERP. Продуктивная схема старта выглядит так: 1) поднять Headscale за реверс-прокси; 2) включить OIDC для онбординга; 3) зарегистрировать первые 3–5 узлов; 4) описать минимальную ACL по принципу наименьших привилегий; 5) включить метрики и логи; 6) проверить два-три ваших ключевых сценария; 7) масштабировать, добавляя теги и subnet routers. Для задач выхода в интернет под персональным IP и повышения приватности в публичных сетях имеет смысл отдельно рассматривать классический персональный VPN — это другая ниша. Для таких случаев у многих команд хорошо заходит вариант с персональным сервером у провайдера вроде vpn.how: выделенный IP на клиента, разные протоколы под конкретную сеть, выбор географии, быстрый запуск и прозрачная тарификация. А вот для внутренней межузловой сетки, DevOps и гибрида лучше работает именно Headscale. В итоге вы получаете устойчивую частную сеть поверх WireGuard, где управление и данные остаются у вас, а подключение новых узлов занимает минуты. Это редкий случай, когда безопасность, удобство и гибкость действительно сходятся в одной точке.
