Répartition de charge VPN sans interruption : algorithmes, contrôles de santé et mise à l’échelle en 2026
Répartition de charge pour serveurs VPN en 2026 : algorithmes, contrôles de santé, persistance de session, mise à l’échelle et résilience. Conseils pratiques, métriques, cas WireGuard, OpenVPN, IPsec et Anycast pour une infrastructure VPN stable.
Contenu de l'article
- Pourquoi équilibrer un vpn et pourquoi c’est crucial en 2026
- Modèles d’architecture pour le load balancing vpn : du l4 à anycast
- Algorithmes de répartition : du simple au sophistiqué
- Contrôles de santé et monitoring : voir la qualité du tunnel, pas juste le port
- Persistance de session vpn : comment « coller » le client correctement
- Mise à l’échelle vpn : verticalement, horizontalement et autoscaling intelligent
- Sécurité et résilience : ddos, zero trust et conformité
- Cas pratiques et modèles pour openvpn, wireguard et ipsec
- Métriques, slo et budget : savoir si tout roule
- Erreurs fréquentes et anti-patterns
- Plan étape par étape pour déployer la répartition vpn
- Cas d’usage concrets : ce qui marche et ce qui ne marche pas
- Checklist avant mise en prod : avons-nous tout couvert ?
- Faq : questions fréquentes sur la répartition vpn
Pourquoi équilibrer un VPN et pourquoi c’est crucial en 2026
Le VPN n’est plus juste du télétravail, c’est un réseau critique
Il y a quelques années, le VPN dans les entreprises signifiait principalement télétravail et accès aux systèmes internes. Aujourd’hui, ça a bien changé. En 2026, le VPN est devenu le transport pour le Zero Trust, les clouds hybrides, les environnements de développement, l’accès aux clusters IA et aux sites edge. Autrefois, la panne d’un serveur était gênante, maintenant une seule minute d’interruption bloque le CI, fait échouer les transactions et impacte votre NPS. La répartition de charge pour les serveurs VPN n’est plus une option, c’est la pierre angulaire de votre fiabilité réseau.
Pourquoi cette montée en charge ? On voit du trafic en temps réel provenant du support vidéo, de la télémétrie IoT, de la synchronisation de données pour l’inférence de grands modèles (LLM) en périphérie. Et oui, le VPN n’est plus « uniquement TCP » : WireGuard et IPsec circulent en UDP, nécessitant une approche différente pour les contrôles de santé, les redirections NAT et la préservation des sessions. On vit à grande vitesse, on scale sans panique. Ou pas ?
L’essentiel est simple : sans une bonne répartition des requêtes entre les nœuds VPN, vous heurtez vite les limites CPU, EPOLL, sockets et tables d’état. Le load balancer est le chef d’orchestre de votre VPN, il empêche les tuyaux de fausser le rythme et tient la cadence en charge de pointe.
Signes typiques de surcharge que vous avez déjà vus
Cela vous parle sûrement : le ping des utilisateurs saute et la bande passante chute en période de forte charge. Le CPU grimpe à 90-100 % sur certains nœuds en sortie, tandis que d’autres sont au repos. Certains se plaignent de reconnexions continues, les pairs WireGuard « disparaissent » quelques minutes, et les connexions OpenVPN cafouillent à cause des timeouts du handshake TLS. Voilà une répartition maladroite où un nœud porte tout le poids pendant que les autres s’ennuient.
Ajoutez à ça des DDoS UDP, des pics soudains après un déploiement ou au début de journée, des routes fluctuantes dans une topologie multi-cloud. Sans une architecture de load balancing bien pensée, vous perdez SLA et argent. Et oui, souvent le remède n’est pas matériel mais algorithmique, avec des contrôles de santé intelligents. Presque gratuit, à condition d’être précis et réactif.
Ce qui change en 2026 : tendances et réalités
DPU/SmartNIC, offload eBPF/XDP, Anycast+BGP en périphérie, load balancers L4 cross-region traitant des millions de paquets par seconde, et autoscaling basé sur de vraies métriques de session sont désormais courants. Nous utilisons de plus en plus Maglev et ring-consistent hashing, construisons la persistance sticky UDP au niveau 5-tuple ou peer-id, et exploitons la reprise de session pour TLS/IPsec IKEv2. Les algorithmes post-quantiques débarquent en pilote, rendant la cryptographie plus lourde. Et tout le monde veut une « mise à l’échelle minimaliste » : moins de rustines complexes, plus de prévisibilité et d’automatisation.
Modèles d’architecture pour le load balancing VPN : du L4 à Anycast
Classique : les load balancers L4 devant le pool de nœuds VPN
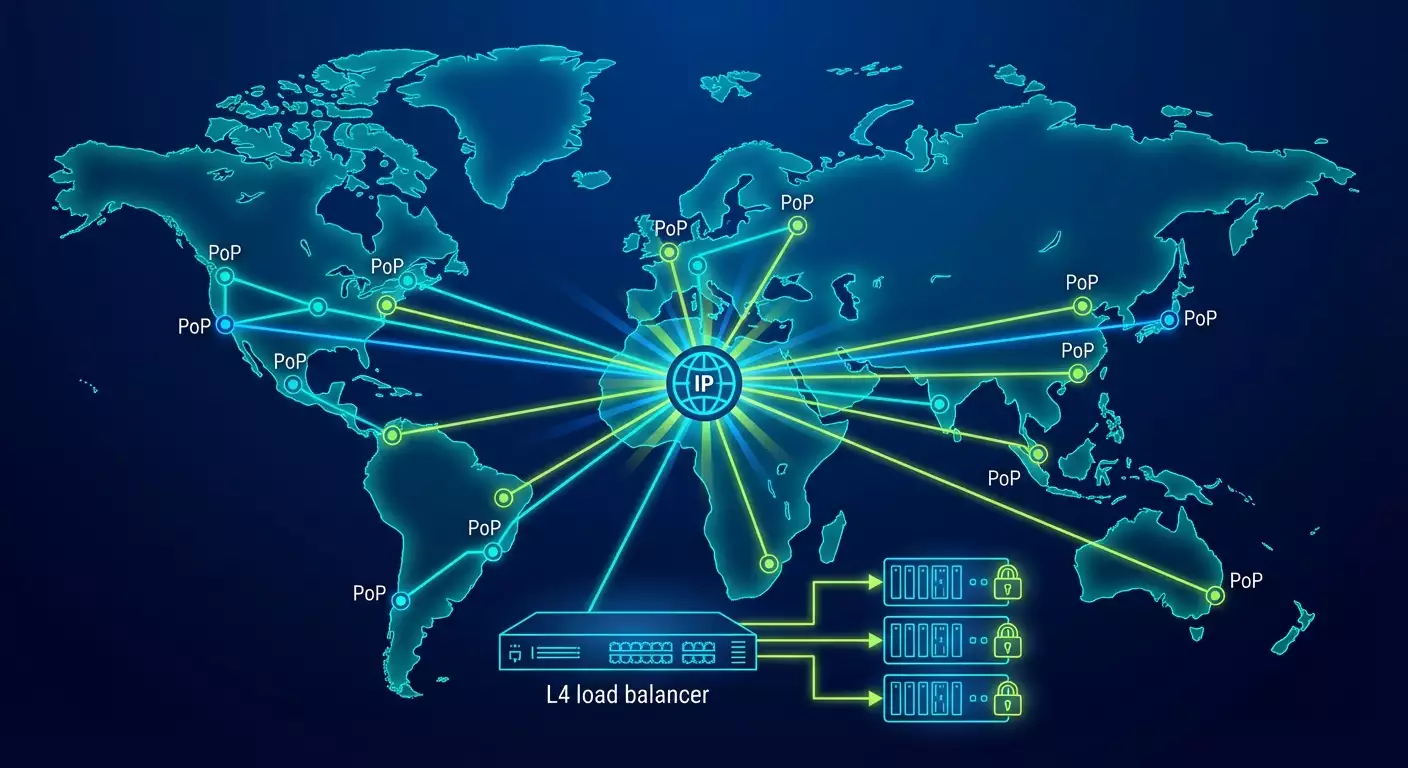
La solution la plus simple est d’installer un load balancer L4 devant votre pool de serveurs VPN, qui accepte les connexions entrantes et les répartit entre les nœuds. Pour OpenVPN (TCP ou UDP), WireGuard (UDP), IPsec/IKEv2 (UDP 500/4500), c’est un schéma éprouvé. Avantages : contrôle centralisé, contrôles de santé, autoscaling simple. Inconvénients : risque de point de défaillance et nécessité d’une bonne sticky, notamment pour UDP.
En pratique, on choisit HAProxy, Nginx Stream, Envoy (L4/L7), ou des NLB commerciaux et cloud avec forwarding direct. L’essentiel est d’assurer un chemin symétrique et la conservation du « flux » sur un même nœud. Pour TCP, c’est simple : la session est stable. Pour UDP, on applique le hash source/destination pour éviter la coupure des tunnels. Sur très gros volumes, on utilise ECMP combiné à un tuning soigneux.
En environnements critiques, on privilégie les paires de load balancers en Active-Active avec VRRP/keepalived ou mécanismes HA intégrés. Et toujours un monitoring hors bande pour vérifier non seulement le port, mais aussi l’état réel des tunnels.
Anycast+BGP en périphérie pour des PoP globaux
Si vous avez plusieurs régions et PoP, Anycast est presque magique. Une même IP est annoncée depuis différents sites via BGP, et l’utilisateur est dirigé vers le PoP le plus proche selon la routage fournisseur. Avantages : latence minimale et géodistribution native. Ensuite, à l’intérieur du PoP, on répartit le trafic entre les nœuds via des load balancers L4 ou DPU. Résultat : une expérience proche d’une CDN pour l’utilisateur.
Anycast demande de bien gérer le flapping des routes, des prepends et community adaptés pour la priorité, et surtout un failover rapide et fiable. Si un PoP tombe, sa route doit disparaître vite. Nous avons des cas avec convergence en moins de 30 secondes sur panne et moins de 5 secondes de bascule interne L4 lors d’un échec santé — les utilisateurs ne voient quasiment rien.
Direct Server Return et passage sans copies inutiles
Pour maximiser le débit, on utilise parfois DSR ou techniques similaires. Le principe : le trafic entrant passe par le load balancer, mais le trafic sortant revient directement des serveurs vers le client, sans repasser par le load balancer. Cela réduit la charge sur le load balancer, mais complique le réseau. En VPN, cette approche est rare car il faut conserver l’état et le chiffrement, néanmoins c’est une option viable pour les gateways IPsec haute performance en datacenter avec routage symétrique.
Attention, DSR complique le débogage, et la visibilité doit rester claire. Si votre équipe n’est pas prête, préférez un classique L4 scalable avec métriques lisibles.
Algorithmes de répartition : du simple au sophistiqué
Round Robin, Weighted RR et pourquoi ce n’est pas suffisant
Le Round Robin est rapide et simple. Mais il ignore la réalité : tous les nœuds ne sont pas équivalents, et la charge est inégale. Weighted RR améliore un peu si vous attribuez des poids basés sur CPU, cœurs ou accélération crypto. Problème : le trafic VPN est inégal, certains clients génèrent des gigabits, des milliers d’autres presque rien. La répartition par connexion ne correspond pas à celle par volume de trafic. Il faut donc un système plus « intelligent ».
Dans les cas concrets, Weighted RR sert souvent de point de départ, puis on intègre télémétrie et ajustement dynamique des poids : par exemple, à 75 % CPU le poids chute de 20 %, à 85 % il tombe de 50 %, etc. Cette adaptabilité n’est pas parfaite, mais elle amortit les pics.
Least Connections / Least Load et métriques adaptatives
Least Connections convient mieux aux connexions TCP (OpenVPN-TCP), où le nombre de connexions actives reflète la charge. Pour UDP (WireGuard, IPsec), on suit les peers actifs et le PPS/BPS. Une métrica récente : « sessions effectives », un nombre pondéré tenant compte du trafic réel des clients sur les dernières secondes. Le load balancer dirige le flux vers le nœud avec la charge « effective » la plus faible. D’où le terme Least Load.
En 2026, c’est monnaie courante : à l’arrivée d’un nouveau peer, on choisit un nœud selon CPU, IRQ softnet, PPS, BPS, drop/queue et nombre de SA actifs (IPsec) ou peers (WireGuard). Les données proviennent d’eBPF/Netlink/Prometheus-exporters et se mettent à jour toutes les 1-3 secondes. Pensez à lisser les fluctuations avec un filtre exponentiel.
Consistent Hashing, Maglev et persistance UDP
Le défi avec UDP : pas de sessions comme TCP, mais un état tunnel à gérer. Il faut une répartition sticky : un client doit être stable sur un nœud, sinon il réinstalle son tunnel, perd des paquets, et s’énerve. On applique du consistent hashing sur le 5-tuple, l’adresse IP source, ou un identifiant unique client. Maglev-hash et ring-consistent hashing assurent la stabilité pour la plupart des clients lors de l’ajout ou retrait de serveurs.
Astuce pratique : si vous avez du CGNAT côté client, l’IP source peut changer. Préférez alors une clé basée sur le certificat client (OpenVPN), la clé publique du peer (WireGuard) ou l’identité RADIUS/AAA. Le load balancer a besoin d’une entité « stable ». Sinon la persistance sera fragile et le tunnel migrera à chaque reconnexion.
Contrôles de santé et monitoring : voir la qualité du tunnel, pas juste le port
Contrôles passifs et actifs
Le simple check TCP/UDP du port est basique, mais insuffisant. On fait des vérifications actives : contrôle du handshake OpenVPN/TLS, IKE_SA pour IPsec, ping direct sur l’interface tunnel ou paquet test pour WireGuard. Un bon contrôle de santé vérifie non seulement si le démon est accessible, mais aussi la capacité à établir un peer test avec échange chiffré. Oui, c’est un peu plus complexe, mais vous identifiez ainsi un processus « vivant mais inutile » avec routage cassé.
On ajoute télémétrie passive : taux de perte de paquets, augmentation des files qdisc, erreurs crypto, pics d’échecs de handshake, et latence en P95/P99. Si P99 dépasse 200 ms sur PoP régional, c’est un signal. Si le taux de drop est au-dessus de 0,1 %, aussi. Vous fixez vos seuils selon votre SLO. En 2026, c’est la norme et non un sujet de débat.
Contrôles multicouches et réseau de vérifications
Un seul contrôle santé, c’est peu fiable. On construit un cascade : pings L4 rapides toutes les 2 secondes, tests fonctionnels élargis toutes les 10-20 secondes, et transactions synthétiques (ex. test de connexion simulant un client) chaque minute. La décision d’exclure un nœud se base sur la majorité des signaux, pour éviter qu’un seul capteur erroné ne coupe le service. Le retour en service suit aussi cette cascade, avec hystérésis.
À cela s’ajoutent des probes externes via vantage points indépendants : agents externes de différents ASN vérifient la disponibilité des nœuds Anycast et mesurent la latence réelle. Cela évite les cas où « tout est vert en interne » mais les utilisateurs souffrent à cause du fournisseur ou d’un problème MTU. Nous avons vu un cas où un chemin alternatif ECMP coupait une partie du trafic alors que le PoP affichait un vert impec. Seule la vérification externe a révélé le vrai problème.
Faux positifs et temporisation
Il y a des erreurs : UDP perd parfois des paquets, le CPU fait un pic momentané, ou le GC ralentit. Utilisez du débounce : N échecs consécutifs, fenêtres d’observation, intervalles exponentiels. Et surtout, loguez non seulement la défaillance mais le contexte — quelles métriques ont franchi les seuils, quelle charge, quels changements de config. Le diagnostic post-incident est votre mise à jour gratuite.
Persistance de session VPN : comment « coller » le client correctement
Sticky sur 5-tuple, IP source et identifiant utilisateur
La base est le stickiness sur le 5-tuple : IP source, port source, IP destination, port destination, protocole. Pour TCP, ça marche bien. Pour UDP, où le port source peut changer, mieux vaut s’appuyer sur une clé plus stable. Pour OpenVPN, ce sera le CN du client dans le certificat ou le nom d’utilisateur RADIUS ; pour WireGuard, la clé publique du peer ; pour IKEv2, l’IDi/IDr ou EAP-ID. Idéalement, le load balancer lit ces champs tôt dans le handshake ou travaille avec un contrôleur fournissant ce mapping.
Plus la clé est stable, moins il y a de migrations. Et l’expérience utilisateur s’en ressent : personne n’aime un tunnel qui saute, même si la reconnexion prend quelques secondes. On a mesuré : déplacer un peer sur un autre nœud lors d’une mise à jour augmente la latence P99 de 30-60 % pendant 1-2 minutes. Solution : bonne sticky et drain mode.
Drain mode, reload gracieux et mises à jour progressives
Vos mises à jour ne doivent pas impacter les utilisateurs. Avant de déployer une nouvelle version ou changer la config, passez le nœud en drain : il n’acceptera plus de nouveaux clients, mais continuera à servir les existants. En 5-15 minutes (selon les timeouts tunnel et activité), la plupart des sessions migrent naturellement sur d’autres nœuds. Puis, faites un redémarrage gracieux — interruption minimale, voire aucune, grâce à la rotation atomique des workers. Ensuite seulement, remettez le nœud dans le pool.
WireGuard est réputé simple, mais attention : recréer l’interface peut réinitialiser l’état des peers. Mettez à jour prudemment : apply atomique de la config, chargement préalable des nouvelles règles, puis bascule. OpenVPN ? Maintenez les sessions grâce à la reprise de session TLS et évitez de forcer le changement de clés en période de pointe.
Partage d’état et annuaire de sessions
Où stocker l’état en cas de migration? Certaines architectures utilisent un annuaire de sessions — un cache central mapping client → nœud, accessible au load balancer et à la couche de contrôle/distribution. Il ne stocke pas tout l’état crypto, mais permet de bien router le prochain handshake. Pour IPsec, c’est la synchro des SA entre nœuds actifs. En 2026, des solutions commerciales et open source répliquent partiellement ou restaurent vite les SA lors d’un failover. La réplication complète n’est pas toujours nécessaire; souvent un handshake rapide avec redirection suffit.
Mise à l’échelle VPN : verticalement, horizontalement et autoscaling intelligent
Croissance verticale : quand elle est pertinente
Processeurs puissants, AES-NI, ChaCha20-Poly1305, accélération DPU — tout cela booste le VPN. Le scaling vertical comble vite un besoin, mais a ses limites : coût en hausse, rendement décroissant, et une panne unique est plus critique. Pour des petites installations (jusqu’à 2-3 Gbit/s), c’est rentable. Au-delà, mieux vaut paralléliser.
Comment savoir si vous êtes au plafond ? Si un nœud tient 10-12 Gbit/s WireGuard à 70-80 % CPU et que les IRQ sont au bord, il est temps d’évoluer horizontalement. Activez tuning NUMA-friendly, pinning des interruptions, RSS, augmentez net.core.rmem/wmem, alignez le MTU, et ouvrez la largeur.
Mise à l’échelle horizontale, clusters et Anycast
L’échelle horizontale est votre alliée. Ajoutez des nœuds, le load balancer répartit les peers, Anycast dirige les utilisateurs vers le PoP le plus proche. Le secret : minimiser le « coût » d’ajout d’un nœud : bootstrap automatique, configs via GitOps, vérification de readiness, intégration dans le pool. Et inversement, un drain simple pour enlever un nœud.
Dans les multi-clouds, on observe typiquement un NLB cloud régional, un pool de VMs WireGuard/OpenVPN derrière, un gestionnaire de config et monitoring externe au-dessus, et en front les IP Anycast annoncées par plusieurs régions. Ça tourne parfaitement tant que les health checks sont fiables et la sticky utilisateur intacte.
Autoscaling sur signaux pertinents
L’autoscaling basé sur CPU seul est trop grossier. En 2026, on scrute les « sessions effectives », PPS/BPS, latences P95/99, échecs de handshake et taux de drop. Les règles sont simples : si la latence P95 augmente de 30 % sur 3 minutes et que PPS dépasse X par nœud, lancez un nouveau nœud. Si la charge baisse régulièrement pendant 15 minutes, mettez un nœud en drain. Pour éviter les oscillations, limite min/max et période de refroidissement sont indispensables.
Attention au coût ! Chaque nœud supplémentaire représente une dépense. Si votre charge est saisonnière (ex. 9h-11h), gardez une réserve « chaude » de 10-15 % au-dessus de la moyenne. Vous payez cela en stabilité et sérénité, car les pics seront mieux gérés.
Sécurité et résilience : DDoS, Zero Trust et conformité
Protection contre UDP flood et spécificités L7
Le VPN circule souvent en UDP, cible privilégiée des attaques DDoS. En périphérie, appliquez filtrage de fréquence, préfiltrage fournisseur, limitation eBPF sur les paquets handshake, tuning conntrack. Activez protection anti-flood sur le load balancer et préférez les whitelist ASN ou géographiques (si business le permet). N’oubliez pas le cookie ou « puzzle » type handshake dans les solutions commerciales — cela réduit votre coût d’attaque et augmente celui de l’attaquant.
Au niveau L7 pour OpenVPN/TLS et IPsec/IKEv2, imposez suites crypto strictes, désactivez les algorithmes obsolètes, pratiquez la Perfect Forward Secrecy, renouvelez les certificats à temps et utilisez HSM/DPU quand justifié. Pas de « MD5 temporairement activé ». Jamais.
Zero Trust et segmentation
Un VPN sans segmentation, c’est une clé pour toutes les portes sur un même trousseau. En 2026, c’est dépassé. Optez pour une politique de routage basée sur les règles, posture device, tokens courts, et identification liée (IdP, MFA). Segmentez aux niveaux des routes, ACL et même zones géographiques PoP. Le load balancer doit comprendre où s’applique la politique et quels nœuds gèrent quel groupe d’utilisateurs. C’est sécurité, performance et contrôle des coûts.
Conformité et journalisation
Les logs VPN sont des preuves légales dans beaucoup d’industries. Stockez métadonnées de connexion, raisons d’échec, versions clients, paramètres cryptographiques. Respectez l’anonymisation quand nécessaire et les règles locales de conservation. Si Anycast redirige un utilisateur vers une autre région, assurez-vous que la politique le permet. La répartition ne doit pas compromettre la conformité.
Cas pratiques et modèles pour OpenVPN, WireGuard et IPsec
WireGuard : UDP rapide et exigeant sur la persistance
WireGuard privilégie minimalisme et rapidité. Pour la répartition, utilisez du L4 avec un hash consistant sur la clé publique du peer. En entrée, Anycast IP sur PoP; à l’intérieur, NLB/HAProxy/Envoy avec ring-hash. Contrôles de santé : peer test, échange keepalive, monitoring du handshake. Pour l’autoscaling : PPS/BPS et nombre de peers actifs. Mises à jour via drain et apply atomique des configs. On a tenu 60 000 peers actifs simultanés avec P99 < 120 ms sur trois régions.
Tuning : net.core.rmem_max, rmem_default, busy_poll sur interfaces, offload NIC adaptés, pinning IRQ sur cœurs. Le cipher ChaCha20-Poly1305 accélère les scénarios CPU-bound. Sécurité : limitez l’arrivée de nouveaux peers sous attaque, activez rate-limit sur les handshakes.
OpenVPN : TCP/UDP et flexibilité
OpenVPN reste un « couteau suisse ». En TCP, la répartition est plus simple : Least Connections avec resumption de session, sticky sur la session TLS. En UDP, appliquez sticky sur le CN du certificat ou le username pour éviter les dérives à la reconnexion. Contrôles de santé : handshake TLS test, ping tunnel, logs renegociation. Pour les grandes installations : séparez plan de contrôle et plan de données, sharding par groupe utilisateur.
Cas client : fintech avec 1 million MAU et pics à 85 000 sessions simultanées. Passage de static RR à Least Load adaptatif sur CPU+PPS+latence P95, ajout du drain-mode en release, -42 % de reconnexions, -35 % latence P99 en soirée. Tout ça sans nouvel hardware.
IPsec/IKEv2 : robuste et un peu plus lourd
IPsec est idéal pour site-to-site et mobiles d’entreprise. Répartition via Anycast en périphérie, puis L4 avec hash consistant sur ID IKE (IDi) ou login EAP. Il faut assurer la synchro correcte des SA en failover. En l’absence de réplication complète, privilégiez un rekey rapide avec redirection correcte. Contrôles santé incluent SA test et suivi de drop ESP. N’oubliez pas NAT-T UDP 4500 et MTU/fragmentation adaptés. Performances grandement améliorées par offload hardware sur SmartNIC/DPU.
Métriques, SLO et budget : savoir si tout roule
Jeu de métriques au niveau des nœuds et cluster
Ne regardez pas que CPU et mémoire. Clé : PPS/BPS entrant et sortant, sessions/peers actifs, taux de handshake, drop/queue sur interfaces, latences P50/P95/P99, erreur crypto, retransmissions TCP, fragmentation UDP. Métriques internes du load balancer : répartition algorithmes, taux de saut sticky, temps de réaction sur échec santé. Ces indicateurs détectent rapidement les anomalies.
Au niveau cluster, surveillez la régularité : coefficient de variation (CV) de charge entre nœuds. Si CV > 0,25 sur durée prolongée, l’algorithme est dépassé ou un client « lourd » perturbe. Mettez en place quotas clients/groupes pour limiter le PPS maximal et éviter que quelques-uns ne détériorent l’expérience de tous.
SLO et alertes sans panique
Définissez votre SLO : disponibilité Anycast PoP à 99,95 % par mois, latence P99 < 150 ms régionale, taux de reconnexion < 1,5 % par heure sur 10 000 sessions, échec handshake < 0,4 %. Déclenchez alertes sur dépassement de seuil prolongé, avec suppression des pics. Les rapports doivent contenir recommandations concrètes : ajouter un nœud, activer drain, vérifier ASN, augmenter MTU, etc.
Coût et planification de capacité
L’argent décide. Planifiez la capacité selon les fenêtres lourdes réelles. Analysez qui crée la charge : le top 1 % de clients ? Trop ? Imposer des limites rate-limit. Gardez 20 % de réserve au PoP, 10 % au global. Associez autoscaling aux budgets pour éviter une explosion la nuit à cause d’un bug métrique.
Erreurs fréquentes et anti-patterns
Répartir sur connexions au lieu de charge réelle
Erreur commune : compter les sessions et se réjouir. Résultat : un nœud garde quelques « éléphants » en trafic, les autres « souris » mais avec égalité en sessions. La solution : métriques PPS/BPS et Least Load pondéré à la charge effective. Ajoutez quotas pour les gros clients.
Contrôle santé « port vivant » uniquement
Un port peut répondre alors que le tunnel est mort. Ajoutez des contrôles fonctionnels, tests synthétiques et probes externes. Employez hystérésis et cascade de décisions pour éviter oscillations lors de pannes temporaires.
Pas de drain mode ni mise à jour douce
Vous faites un rollback, les utilisateurs se déconnectent massivement, SLA chute. Ne jouez pas les héros. Activez drain, patientez le départ naturel des sessions, appliquez la maj, remettez en pool. Calme et sans à-coups.
Plan étape par étape pour déployer la répartition VPN
Étape 1. Mesurez, ne supposez pas
Collectez métriques : PPS/BPS, peers, taux handshake, latence, drop. Tracez profils temporels et identifiez pics. Sans données, tout est devinette.
Étape 2. Choisissez l’architecture
Petite et moyenne échelle : load balancer L4 devant pool, sticky par identifiant utilisateur, contrôles santé avec peer test. Grande échelle : Anycast+BGP en périphérie, NLB/HAProxy/Envoy en interne, autoscaling et probes externes par ASN.
Étape 3. Configurez algorithmes et sticky
Démarrez avec Least Load et hash consistent sur identifiant stable (CN, clé publique, IDi). Vérifiez stabilité lors d’ajout/retrait de nœud. Activez quotas pour gros clients et migration douce avec drain.
Étape 4. Contrôles santé et cascade de décisions
Déployez checkers L4 rapides, tests fonctionnels lents, et probes externes synthétiques. Fixez seuils, fenêtres, politique de retour. Documentez tout — vous vous remercierez au premier incident.
Étape 5. Autoscaling et budget
Reliez autoscaling aux métriques qualité (P95, drop) et charge (PPS/BPS). Définissez nombre min/max de nœuds, budgets, temps de refroidissement. Testez en laboratoire avec « tempête » de connexions et attaque UDP.
Étape 6. Sécurité et conformité
Vérifiez la politique crypto, logs et segmentation. Mettez en place rate-limit sur handshake, filtres en périphérie, et ajustez MTU. Pensez SmartNIC/DPU si le prix est justifié.
Cas d’usage concrets : ce qui marche et ce qui ne marche pas
Cas 1 : fintech et pics en soirée
Client avec pic soir : rapports analytiques mobiles via VPN, jusqu’à 85 000 sessions simultanées. Passage de Weighted RR à Least Load, sticky sur CN, drain-mode activé, triple niveau de contrôle santé. Résultat : -35 % latence p99 au pic, -42 % reconnexions, économie de 2 nœuds grâce à une répartition équilibrée.
Cas 2 : Anycast et multi-cloud
SaaS global avec PoP dans 6 régions. Anycast dirige vers PoP le plus proche, interne, NLB avec ring-hash sur clé publique WireGuard. Monitoring externe a permis d’éteindre une région dégradée en 20-30 s via BGP et contrôles rapides. Disponibilité trimestrielle à 99,97 % obtenue.
Cas 3 : DDoS et saturation des handshakes
Flood UDP sur ports WireGuard a déclenché avalanche de handshakes. Limitation eBPF rate-limit, validation cookie à l’étape handshake, filtrage renforcé chez le fournisseur activés. Fréquence des reconnections clients réduite. P95 retrouvé en 7 minutes, impact business limité à un léger ralentissement d’une douzième d’heure.
Checklist avant mise en prod : avons-nous tout couvert ?
Technique
- Algorithme de répartition : Least Load + hash consistent
- Sticky sur identifiant client stable
- Cascade de contrôles de santé : rapide, fonctionnel, externe
- Drain mode et mises à jour douces
- Autoscaling sur P95/PPS/BPS et limites budgétaires
- Logs, alertes, SLO et post-mortem
Réseau
- Anycast+BGP pour PoP globaux
- MTU corrects et fragmentation
- Symétrie ECMP et diagnostic route
- Filtres en périphérie, rate-limit handshake
Organisation
- Documentation et runbook
- Test incident et simulation de « tempête »
- Validation conformité par région
- Plan de rollback en 5 minutes
FAQ : questions fréquentes sur la répartition VPN
Quel algorithme choisir pour commencer ?
Commencez par Least Load avec hash consistant sur identifiant client stable. Cela assure répartition équilibrée et stabilité des sessions sans rebonds lors d’ajout de nœuds. Réservez Round Robin au test en labo.
Faut-il Anycast si on est dans un seul pays ?
Si vous avez plusieurs régions dans un même pays et des utilisateurs géographiquement distribués, Anycast diminue la latence et sécurise la disponibilité des PoP. Sur une seule ville avec un PoP unique, l’intérêt est limité : concentrez-vous sur un bon L4 et contrôles santé.
Comment faire la persistance pour WireGuard ?
Utilisez un hash consistant sur la clé publique du peer. C’est plus fiable que l’IP source, surtout en CGNAT. Au niveau du load balancer ou contrôleur, stockez le mapping peer → nœud pour éviter que le handshake parte ailleurs.
Que vérifier dans les contrôles santé au-delà du port ?
Handshake, échange de paquets test sur tunnel, latence P95/P99, taux de drop, erreurs crypto, croissance des files d’attente. Probes externes depuis différents ASN sont indispensables pour détecter les problèmes fournisseurs.
Comment mettre à jour sans interruption ?
Activez drain mode, attendez le départ naturel des sessions, appliquez redémarrage gracieux ou sans coupure. Pour WireGuard, appliquez la config atomiquement; pour OpenVPN, utilisez session resumption; pour IPsec, rekey rapide avec redirection correcte.
Faut-il investir dans DPU/SmartNIC ?
Si vous avez plusieurs dizaines de gigabits par nœud et avez besoin d’une faible latence sous charge, oui. Pour petites installations, mieux vaut bien régler le load balancing L4, l’autoscaling et le réseau.
Quels SLO fixer au démarrage ?
Disponibilité 99,9-99,95 % sur les PoP, latence P99 < 150 ms pour utilisateurs régionaux, taux de reconnexion < 2 % par heure sur 10 000 sessions, erreurs handshake < 0,5 %. Durcissez avec la maturité.
